この記事についてClaude(Anthropic)との共同編集により作成されました。
要約
- Kaggleの細胞トラッキングコンペで 4,020チーム中438位・メダルなし。銅メダルの線まで あと0.001 だった
- 一言でいうと、曲がったレンズのメガネをかけて、錆びたツルハシを一生懸命振っていた愚か者が私である。序盤に信頼できる道具と物差しを用意しなかったのが根本
- 錆びたツルハシ=公開ノートを土台にした入り方と、学習し切っていない自作の検出器
- 曲がったレンズ=学習に使ったデータで測る計器と、誤差の範囲内でしか差の出ないpublic LB
- 終盤は手持ちのOOFを捨てて、public LBの0.001〜0.003の差で選んだ。後で数えたら、この幅の差が privateでも同じ向きに出たのは 17対中7対。ほぼコイン投げである
- 時間配分も悪かった。本格始動は期間の37%が過ぎてから、主戦場に決めたのは84%が過ぎてから。別コンペとColabのGPUを食い合っていた
- それでも、この失敗は必要だったと思っている。別コンペと両取りのまま進めていたら、何が悪いか分からないままだった可能性がある
はじめに
2026年9月29日に締め切られたKaggleのコンペ「Biohub - Cell Tracking During Development」に出て、メダルを逃した1。
| 項目 | 値 |
|---|---|
| 最終順位 | 438位 / 4,020チーム(上位10.9%) |
| メダル | なし |
| private スコア | 0.919 |
| 銅メダルの線 | 0.920(あと0.001) |
| private 1位 | 0.977 |
| 賞金 | $60,000 |
| 期間 | 2026-06-29 〜 2026-09-29(92日) |
ROGII2、AI Agent Security3と2連続で銀を取ってきて、今回は無冠である。金が取れる見込みはもともと無かったので、メダルなしという結果は真摯に受け止める。
そのぶん振り返りは念入りにやった。締切後に上位の解法29本と、自分の全164提出のpublic/privateを突き合わせて、判断を1つずつ検証した。この記事はその反省会の議事録である。全部を詳細には書かないが、悪かった点は全部並べる。
何のコンペだったのか
ゼブラフィッシュの胚を3D顕微鏡でタイムラプス撮影した動画から、細胞を追跡するコンペだった。
- 各フレームで細胞の中心を見つける(検出)
- 隣のフレーム同士で、同じ細胞をつなぐ(リンク)
- 細胞が2つに分かれる瞬間を拾う(分裂)
採点は、正解の「細胞と細胞のつながり(辺)」をどれだけ当てたかのJaccard係数で、分裂の当たりにも少し加点がある。細胞を出しすぎると減点される仕組みもあった。
厄介だったのは正解ラベルが疎なことだ。画面に映っている細胞の一部にしか注釈が付いていない。注釈が無いところに細胞がいないとは言えないので、「ここは背景です」と教えられない。
もうひとつ、採点用の隠しデータは学習データとは別の胚だった。public LBは胚A(細胞が密)、private LBは胚B(疎)で、どちらも学習データには無い。public LBで良いものがprivateでも良いとは限らない、というのが後で効いてくる。
総括:曲がったメガネをかけて錆びたツルハシを振っていた愚か者は私です
振り返りを全部終えたあと、自分の言葉で一文にまとめたのがこれである。
序盤に信頼できる道具を用意しておくことが重要で、私は曲がったレンズのメガネをかけて、錆びたツルハシを一生懸命振るっていたようなものだった。
| たとえ | 実際に何だったか |
|---|---|
| 錆びたツルハシ | 公開ノートを土台にした入り方。学習し切っていない自作の検出器 |
| 曲がったレンズ | 学習に使った動画で測る計器(in-sample)。誤差の範囲内でしか差の出ないpublic LB |
ツルハシが錆びているので掘れない。レンズが曲がっているので、掘れたかどうかも正しく見えない。それなのに本人はやる気だけは満々で、実験ノートを約230本書いた。汗だけかいて、どっちに掘っているのかも分かっていない。アイキャッチのモグラは、だいたいこの3ヶ月の私である。
結果:何が起きたか
まず結果の全体像から。
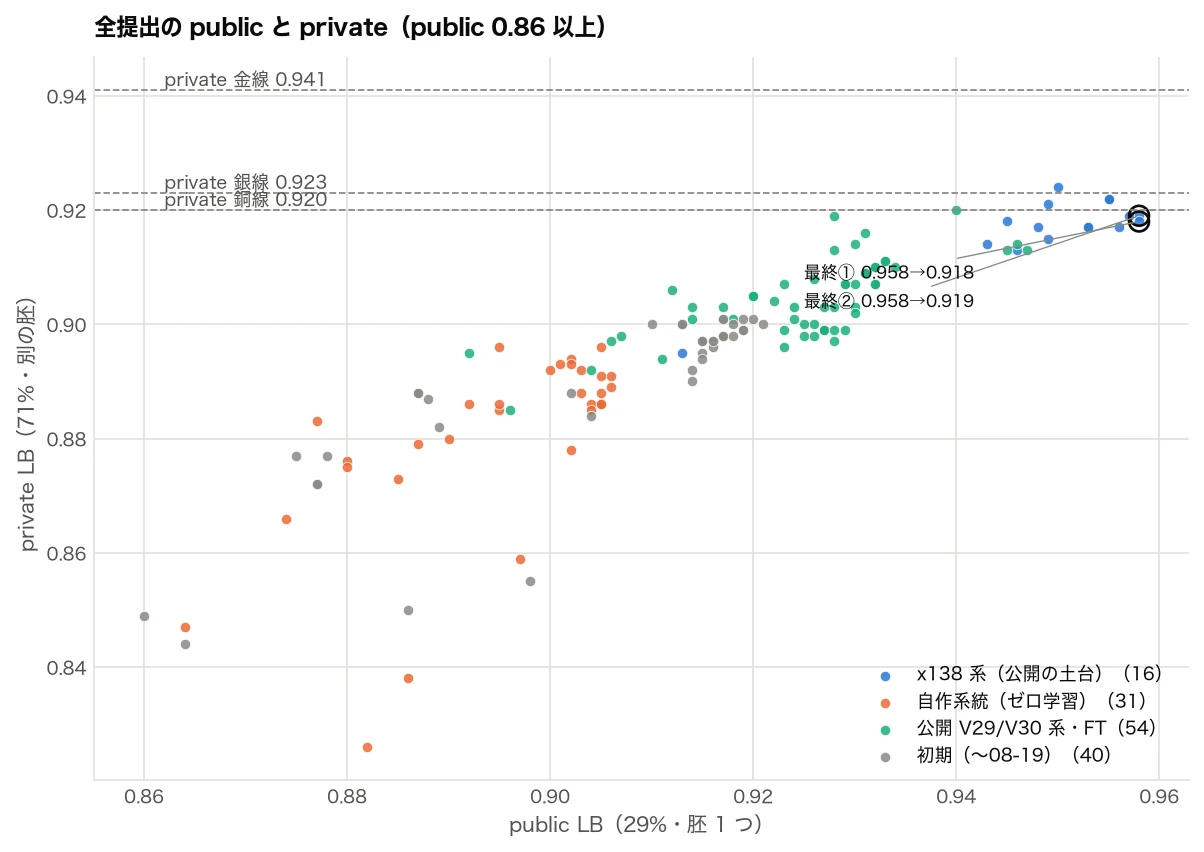
右上の丸が最終2枠である。public 0.958で自分の中では最高だったが、privateでは0.918と0.919に落ちた。
全体ではpublicとprivateの相関は高い(r = 0.87)。崩れたのは右上の細かい差の部分だけで、そこで最終判断をしたのが致命傷になった。
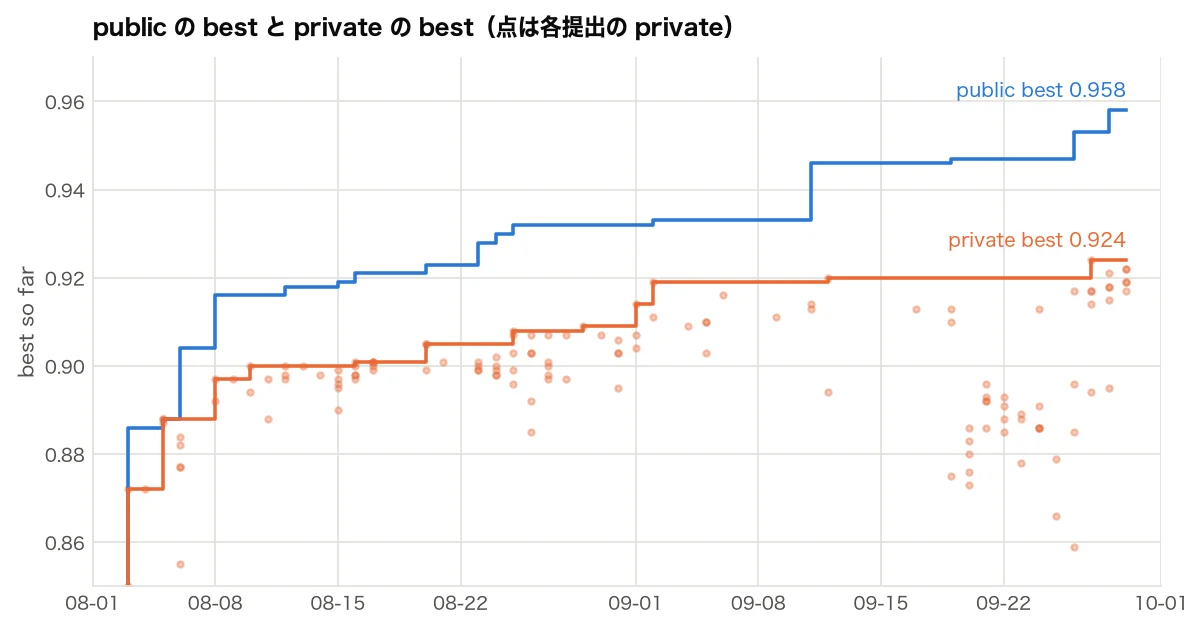
publicのベストは9月に入ってから0.933→0.958と伸び続けていた。一方でprivateのベストは、9月12日から27日までの2週間、0.920のまま一度も更新されていない。この2週間、伸びていると思っていたのはpublic LBに合わせていただけだった。
悪かった点の一覧
先に全部並べておく。
| 箱 | 悪かった点 |
|---|---|
| 時間とGPU | ①本格始動が期間の37%経過後 ②主戦場に決めたのが84%経過後 ③別コンペとColabを食い合った |
| ツルハシ(道具) | ④公開ノートを土台に入った ⑤自作の検出器を学習し切らなかった ⑥強い後処理に載せなかった ⑦理論どおりのPU学習に寄せて5日遠回り ⑧外部データの事前学習を的外れな前例で捨てた ⑨分裂の正例を増やす作業をしなかった ⑩論文を読んだのが9月 |
| レンズ(計器) | ⑪foldを初日に切らなかった ⑫8月の6週間はin-sampleで評価していた ⑬最終的に出す系統のOOFが最後まで無かった ⑭別の胚への転移を確かめる検査が無かった ⑮段に分けて評価しなかった ⑯学習の長さをlossで決めた |
| 終盤の判断 | ⑰OOFを捨ててpublic LBで決めた ⑱採否ルールの閾値が誤差の内側だった ⑲閾値や出力数をpublicの胚に合わせた ⑳最終2枠が実質1枚だった ㉑最後の悪あがきで自作と公開を混ぜなかった ㉒保留した案に戻る仕組みが無かった |
時間とGPU:始めるのも決めるのも遅かった
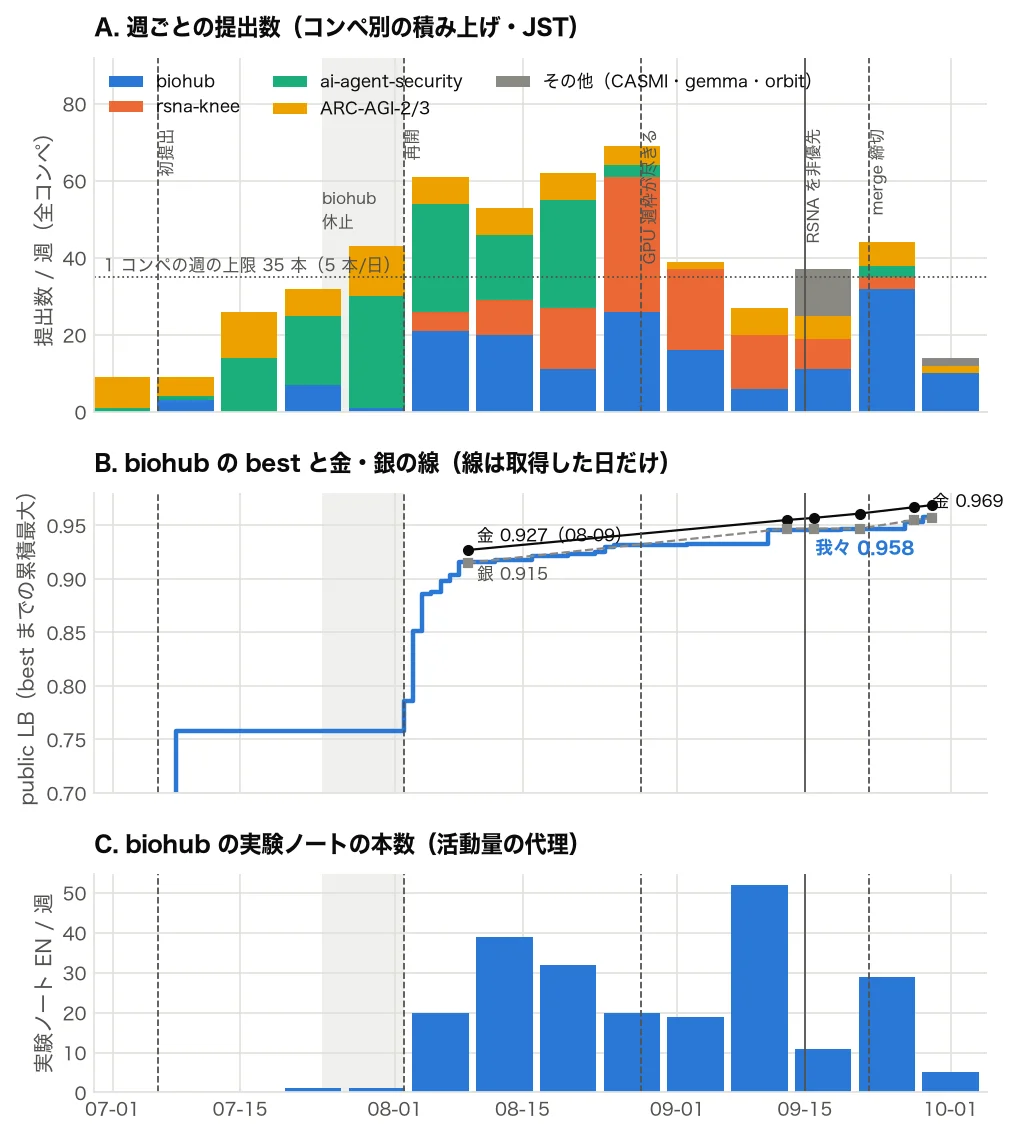
①本格始動が遅かった。 最初の34日間、このコンペへの提出は10本だけで、提出枠の使用率は6%。7月下旬は完全に休止していた。学習ベースの手法で0.9台に乗ったのは8月2日以降の2週間で、これを7月に置けていれば、後の1ヶ月の横ばいを別の探索に使えた。
②主戦場に決めたのが遅かった。 8月2日〜9月14日は、提出の69%が別のコンペだった。「このコンペをメインにする」と決めた痕跡は9月15日で、残り15日しかなかった。上の図Bを見ると、8月9日時点で金との差は−0.011。締切時点でも−0.011。1ヶ月半、場の伸びについていっただけで、差は1ミリも縮んでいない。
③別コンペとColabを食い合った。 一番効いたのはこれだ。並行していたRSNAのコンペとGPUを取り合って、長い学習が何度も待たされた。8月28日には週60時間のGPU枠が尽きている。前回の記事3で「律速はGPU枠」と書いたが、それをそのまま踏んだ。
ただし、「早く1つに決めて集中すれば勝てた」とも思っていない。実際、集中した後の終盤で崩れている。並行するならGPUの取り合いにならない組み合わせにする、が正しい教訓だと思う。
ツルハシ:道具が錆びていた
④公開ノートを土台に入った。 序盤から公開ノートをベースに実験を始めたのが、入り方として間違っていた。公開ノートの重みは学習データ全部で学習済みなので、手元のどの動画で測っても「見たことのある動画」での成績になる。入り口でレンズが曲がったのはここである。次からは小さなモデルを自分で学習するところから始める。理解も深まるし、5 foldを全部回しても安い。
⑤自作の検出器を学習し切らなかった。 自作の検出器を本格的に回したのは9月12日からで、それも40 epochで止めた。止めた理由は「validationが10 epochあたりから横ばい」と「ColabのGPUが足りない」。ところが後で見ると、学習を伸ばすたびにprivateは上がっていた(19→39 epochで+0.015、39→59 epochで+0.012)。しかも、止める判断に使ったvalidationは正解の辺の0.69%しか見ていない弱い計器だった。座標を細かく補正するoffsetヘッドも付けていなかった。
同じく公開ノートを土台にした9位の人の自作検出器は、単体でprivate 0.916。こちらは0.875〜0.885。差は型ではなく学習条件のほうである。
⑥強い後処理に載せなかった。 同じ公開の重みを、自作の後処理に載せるとprivate 0.859、公開ノートの後処理に載せると0.913。自作系統の弱さの大半は、検出より後ろにあった可能性が高い。それなのに、自作の検出器を公開ノートの後処理に差し込む案(9月26日に書いていた「案A」)は、一度も実行しなかった。
⑦理論どおりのPU学習に寄せて5日遠回りした。 疎なラベルに対して「注釈の無いところを背景と決めつけない」PU学習を入れた。方向は正しかったし、privateでも+0.030効いた。自作系統で最大の改善である。ただ、理論形のnnPUを素直に入れたら、注釈のある細胞の出力が暴走して50本中33本で全滅した。診断して修正して再学習するまでに約5日と、Colabの数十ユニットを使った。上位はみんな「注釈あり/確実に背景/不明(重み0)」の3段で重みを付けるだけで、同じ地点に診断なしで着いている。
⑧外部データの事前学習を、的外れな前例で捨てた。 外部の密なラベル付きデータ(Zebrahub)で事前学習する案は、序盤からアイデアに残っていた。それを退けた理由のひとつが「合成データで事前学習したらデコーダが壊れた前例」だった。前例は合成データで、実画像のZebrahubではない。 5位はZebrahubで事前学習してからfine-tuneし、privateで+0.016を得ている。我々は同じデータを同時に混ぜて学習し、private 0.826に崩れた。同じデータでも、混ぜ方で結果が逆になる。
⑨分裂の正例を増やす作業をしなかった。 8月8日に「分裂の正例が24件しかないので画像分類器は学習できない」と判断して見送った。判断自体はその時点では妥当だが、「正例が増えれば戻る」と書いたまま、増やす作業をしなかった。1位は初期の検出器で分裂候補を掘り出し、目で確認して151件→515件に増やしている。上位1・3・4位では、分裂を画像で読むモデルが中核だった(4位はこれで+0.035)。
⑩論文を読んだのが9月だった。 アーキテクチャを公開ノートに引っ張られ、論文を調べて実装するのが後回しになった。ただし、上位を見ると出力の型(ヒートマップかflow場か)が決め手だったわけではない。共通していたのは自作の検出器+疎ラベル用のlossである。
レンズ:物差しが曲がっていた
⑪foldを初日に切らなかった。 交差検証の分割を切ったのは9月13日。期間の4分の3が過ぎていた。
⑫8月の6週間は、in-sampleで評価していた。 8月にも検証用の分割はあった。しかし評価していたのは、学習データ全部で学習済みの公開重みと、そのfine-tuneである。fold自体は正しくても、評価するモデルが評価する動画をすでに見ているので計器として成立していなかった。重みを触る施策で2回、符号を外している。
⑬最終的に出す系統のOOFが、最後まで無かった。 自作系統にはOOF(学習に使っていない動画での予測)があった。しかし最後に乗り換えた公開ノート系統にはOOFが無く、in-sampleの計器とpublic LBだけで判断した。上位1〜3位は、最終的に出す系統そのもののOOFを持ち、公式の評価指標で1段ずつ積み上げていた。
⑭別の胚への転移を確かめる検査が無かった。 隠しデータは別の胚なのに、どのfoldも両方の胚を含む動画単位の分割だった。学習用の分割としては妥当だが、「胚をまたぐと向きが変わるか」を確かめる2-foldを別に持つことはしなかった。4位はこれで、同じ胚の検証が過大評価した変更を弾いている。ほかにも、同じ領域を切り出した動画が重複していてfoldをまたいで漏れる経路(12位が報告)を確認していない。
⑮段に分けて評価しなかった。 公開ノートの検出はin-sampleでしか測れなくても、後処理の段だけなら測れた。自作検出器のOOFを入力にして、後処理の設定だけを変えて比べればいい。段を固定して1段だけ動かす比較は、全体のスコアで比べるより雑音が少なく、解像度が高い。実際、分裂の出し方を変えた比較では、この段の計器とprivateは同じ向きを指し、public LBだけが逆を言っていた(どれも誤差ぎりぎりで、確定とまでは言えないが)。
⑯学習の長さをlossで決めた。 validation lossが横ばいになったのを見て学習を打ち切ったが、loss と最終指標は両方向に食い違っていた。疎ラベルでは、モデルが注釈の無い本物の細胞に反応するようになるほど背景の損失が上がる。検出が良くなるほどval lossが悪化しうるので、lossは学習の長さを決める物差しにならない。見るべきだったのは、hold-outでの最終指標そのものである。
終盤の判断:誤差の内側で選んだ
ここが一番痛い。
⑰OOFを捨ててpublic LBで決めた。 最後の4日間、公開ノート系統(0.953)に乗り換えてから、選択はすべてpublic LBの0.001〜0.005の差で決めた。自分のルールには「public LBは信頼区間±0.011。publicだけで採否を決めない」と書いてあったのに、である。OOFが出せなくても、代理の指標で判断すべきだった。
締切後に、条件を1つだけ変えた提出の対で、publicとprivateの向きが一致したかを数えた。
| publicの差の大きさ | privateでも同じ向きだった対 |
|---|---|
| 0.0035未満 | 7 / 17 |
| 0.0035〜0.0065 | 4 / 6 |
| 0.0065〜0.0115 | 4 / 7 |
| 0.0115以上 | 7 / 7 |
publicの0.001〜0.003の差は、privateの向きについて何も教えてくれない。 0.0115以上の差なら、全69対で11/11が一致した。終盤の判断はほぼ全部、表の一番上の行でやっていた。
⑱採否ルールの閾値が誤差の内側だった。 終盤の候補は、事前に決めたルール「publicで−0.002以上負けたら出さない」でふるい落としていた。事前登録して手続きどおりに運用したこと自体は正しい。間違っていたのはルールの閾値のほうで、上の表の「当てにならない帯」の中に線を引いていた。手続きだけは几帳面なのに、判定の中身はコイン投げ。真面目な顔でサイコロを振っていたことになる。
⑲閾値や出力数をpublicの胚に合わせた。 検出の閾値や出力する細胞の数は、全部public LBを見て決めていた。ところが自作系統では、「privateとpublicの差のズレ」が「出力した細胞の数の増減」と順位相関0.69で連動していた。細胞を多く出す変更はprivateで得をし、減らす変更はpublicで得をする。疎なprivateの胚では、多めに出すほうが良かったのである。4位は胚の密度を判定して閾値を切り替えていた。我々は運用点を1つに固定し、それを密なpublicの胚に合わせていた。
さらに、公開ノートの設定は作者と掲示板の人たちがpublic LBを見て詰めたものだ。そこからどこを動かしても、publicでは下がりやすい。実際、そこからの変更15対のうち13対で、privateのほうがpublicより良く出た。逆だった唯一の対が、我々がpublic +0.005で選んだ最終提出である。
⑳最終2枠が実質1枚だった。 最終2枠は、出力数が1.1倍違うだけの同じ札を2枚出した。結果は0.918と0.919。「同じ端から2枚採るのは1枚」という自分の過去の教訓に、そのまま当てはまる。
これは正直に言うと半分意図していた。手堅くメダル圏を守るより、少しでも高いスコアに賭けて負けた感覚である。ここは受け入れている。
㉑最後の悪あがきで、自作と公開を混ぜなかった。 終盤、「公開か自作か」の二択で公開だけを選んだ。9位は同じ公開ノートを土台に、自作の検出器6本を1:1で混ぜてprivate +0.023を得ている。我々も「案A」として同じ型の案を書いていたが、実行しなかった。いずれにせよ金には届かなかっただろうが、勝負するならハイブリッドだった。
㉒保留した案に戻る仕組みが無かった。 flow場の出力ヘッド、案A、Zebrahubの事前学習。どれも保留するときに「こうなったら戻る」という復帰条件を書いていて、条件はちゃんと発火していた。それでも戻らなかった。記録は正しく書けていたが、発火を検知して戻る手順が無かった。
上位との差
上位の解法29本を読んで、共通する要素を6つ拾った。
| 上位に共通していたもの | 我々 |
|---|---|
| 自作の検出器を、疎ラベル用のlossで学習 | 試したが、学習し切らず、強い後処理に載せなかった |
| Cellpose型のflow場で細胞の中心を取る | 検討して保留、戻らなかった |
| 分裂を画像で読む | 正例24件で見送り、増やさなかった |
| 分裂を足す(出力数を増やす) | publicで負けたので捨てた(privateでは得だった) |
| 辺・分裂・ノードを同時に最適化 | 公開の最適化をそのまま使った |
| 最終的に出す系統の全体OOFで判断 | 最後の系統にはOOFが無かった |
部品の多くは手元にあった。足りなかったのは、それを最後まで研いで、正しい物差しで測ることだった。金との差(private −0.022)は、部品を足し算すれば埋まる差ではなく、土台そのものの差である。
良かったこと
全部ダメだったわけではないので、良かったことも書いておく。
- 仕組みの読みは上位と一致していた。「公開の最適化は分裂を作らない」「密な領域では検出のピークが潰れる」といった観察は、上位の解法でも同じことが指摘されていた。手を打たなかっただけで、見えてはいた
- 座標ヘッドの学び直しは手法として正しかった。他の2チームが独立に同じスコアに着いている
- 事前登録・1枠1因子・提出台帳の運用のおかげで、締切後に69対の向きを数えられた。この記事の表はほぼ全部、この台帳から出ている
次のコンペに持ち越すこと
- 小さな自作モデルから入る。公開ノートは後から部品として借りる
- 初日に全データを覆う5-foldを切る。重複した切り出しを1つの群にまとめ、密度や胚で層化する。転移の検査用に、グループをまたぐ分割も別に持つ
- 評価するモデルが評価データを見ていないか、毎回確かめる
- 最終的に出す系統のOOFを持つ。公開の重みに乗るなら、自作の部品を差してOOFの効く部分を作る
- 段ごとの計器を持つ。入力をOOFに揃え、1段だけ変えて、その段の指標で読む
- publicの差が誤差の外になければ選ばない。事前登録ルールの閾値も誤差の外に置く
- public とprivateが別のグループなら、閾値や出力数は2枠でヘッジする
- 最終2枠の前にチェックリストを埋める。2枠は同じ端か、publicの差は誤差の外か、別の根拠で選んだ最良の札は何か、運用点は2枠で同じか
- 保留した案の復帰条件を、引き継ぎメモを書き直すたびに確かめる
- GPUの取り合いになるコンペは並行させない
おわりに
ダメすぎたが、こけまくったおかげで学びがめちゃくちゃあるコンペだった。
そして、この失敗は必要だったと思っている。RSNAとの両取りのまま進んでいたら、銀は取れていたかもしれない。でもその場合、何が悪いかわからないままメダルを取っていた可能性がある。このコンペにのめり込んでから、注釈がどう作られているか(疎なGT、z方向の位置の置き方、胚ごとの規約)に気を配れるようになった。これは結果ではなく理解の側の収穫で、次のコンペに持ち越せる。
前回の記事の結論は「AIがもう打つ手がないと言ったところから、もう1回だけ測る」だった。今回はその手前の話で、測る道具そのものが曲がっていたら、何回測っても意味がない。
曲がったメガネをかけて錆びたツルハシを全力で振っていた愚か者は、私である。次は、メガネを直してツルハシを研ぐところから始める。
参考リンク
- Biohub - Cell Tracking During Development(Kaggle) https://www.kaggle.com/competitions/biohub-cell-tracking-during-development
- Kaggle ROGIIコンペで銀メダル──public 397位が private 231位に。提出枠を使わずスコアを検算した1ヶ月 https://yurudeep.com/posts/deeplearning/2026/20260806/
- Kaggle AI Agent Securityコンペで銀メダル113位──本当の限界は「もう打つ手がありません」の先にある https://yurudeep.com/posts/deeplearning/2026/20260904/