この記事についてClaude(Anthropic)との共同編集により作成されました。
要約
- DINO は Meta(FAIR)が作った、ラベルなしの画像だけで学習する画像エンコーダのシリーズである。画像を入れると、画像全体の特徴ベクトルと、小区画(パッチ)ごとの特徴ベクトルが出てくる
- 単体では分類も検出もしない。特徴の上に小さなヘッド(線形層・デコーダ・最近傍検索など)を載せて、分類・検索・セグメンテーション・深度推定・異常検知などに使う
- 初代 DINO(2021)は、ラベルなしで学習した ViT の注意マップに物体の輪郭が勝手に現れることを示した原点。DINOv2(2023)は大規模化して、ファインチューニングなしでそのまま使える汎用特徴を実現した
- DINOv3(2025)は 7B パラメータ・17 億枚まで拡大し、Gram anchoring でパッチ特徴の劣化を解消した。バックボーンを凍結したまま検出・セグメンテーションで SOTA 級になる
- CLIP / SigLIP は言葉と結びついた意味に強く、DINO はテキストを使わないぶんピクセル単位の細かい特徴に強い。VLM やロボットでは両方を併用する例が多い
- Grounding DINO や DINO-DETR は名前が同じだけの別物の物体検出器。ライセンスは DINO / DINOv2 が Apache 2.0、DINOv3 は独自の DINOv3 License(商用可だが軍事用途などは禁止)
きっかけ
前回の記事に続いて、Kaggle の RSNA Knee Abnormality Detection(膝の MRI から異常を見つけるコンペ)の話から入る。コンペの公開ノートブックを眺めていると、メインのバックボーンに DINOv2 や DINOv3 を据えたものがよく目についた。
前回は Swin・ConvNeXt・CoAtNet のような「アーキテクチャ」の系統を整理した。ところが DINO はアーキテクチャの名前ではなく、中身は ViT(DINOv3 には ConvNeXt 版もある)である。では DINO とは何なのか。v2 と v3 は何が違うのか。検索すると Grounding DINO という名前も出てきて、それが同じ系統なのかも分からない。
そこで DINO・DINOv2・DINOv3 を論文と公式リポジトリベースで調べて、仕組みから「何と組み合わせると何に使えるか」までを整理した。DINO を知らない人から中級者までを想定している。CNN や ViT の基本があやしい場合は、一問一答で学ぶ画像認識モデルのアーキテクチャ構造を先に読むとよい。
先に答えを書いておくと、DINO は画像の「目」にあたる部品で、それ単体では何も答えを出さない。後ろに何をつなぐかで、分類器にも検索エンジンにも、深度推定器にも異常検知器にもなる。v2 以降は、その「目」を凍結したまま使えるところに価値がある。
前提知識:DINO を理解するための 4 つの言葉
自己教師あり学習(Self-Supervised Learning, SSL)
普通の画像認識モデルは「この画像は犬」という人手のラベルで学習する。自己教師あり学習は、ラベルを使わず、データ自体から学習の手がかりを作る方法である。
DINO の場合は「同じ画像を切り抜き方や色合いを変えて 2 通り見せても、同じ特徴になるようにする」という課題を自分で解く。ラベル付けのコストがかからないので、数億〜数十億枚の画像で学習できる3。
バックボーン(エンコーダ)とヘッド
画像モデルはだいたい次の 2 段構成になっている。
画像 → [バックボーン] → 特徴ベクトル → [ヘッド] → 答え(クラス、マスク、深度…)DINO が提供するのはバックボーンの部分。ヘッドは用途に合わせて利用者が付ける。
ViT とパッチ・CLS トークン
DINO の主力モデルは Vision Transformer(ViT)。ViT は画像を 14×14 や 16×16 ピクセルのパッチに分割し、それぞれをトークンとして扱う。出力は主に 2 種類ある。
| 出力 | 何を表すか | 主な用途 |
|---|---|---|
| CLS トークン(1 本) | 画像全体の要約 | 分類、画像検索、クラスタリング |
| パッチトークン(パッチ数ぶん) | その場所に何があるか | セグメンテーション、深度推定、対応点探索、異常箇所の特定 |
後者のような位置ごとの特徴を密な特徴(dense features)と呼ぶ。DINO 系の強みはここにある3。
凍結(frozen)して使う
DINOv2 以降の売りは、バックボーンの重みを一切更新せず(凍結)、上に載せた小さなヘッドだけを学習しても高性能という点である23。少ないラベル・少ない計算資源で済み、1 回の推論結果を複数タスクで使い回せる4。
DINO(2021)── ラベルなしで物体の形が見えた
名前と基本アイデア
DINO は self-DIstillation with NO labels(ラベルなしの自己蒸留)の略1。論文は 2021 年 4 月公開、ICCV 2021 採択。
仕組みは先生(teacher)と生徒(student)の 2 つのネットワークで構成される1。
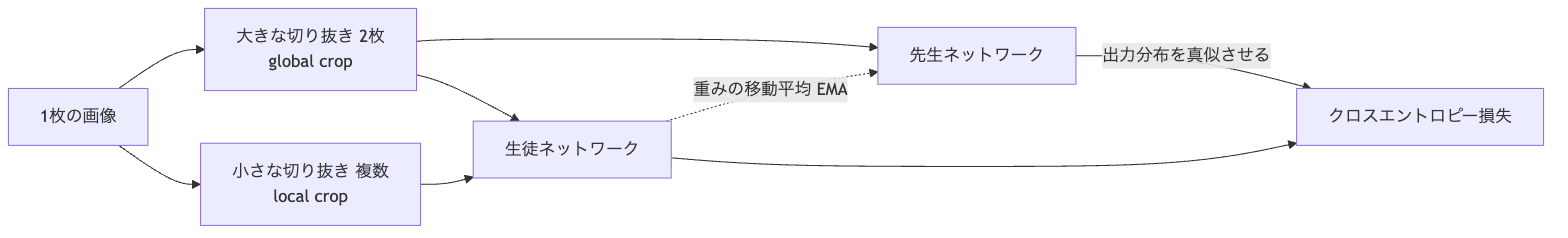
- 1 枚の画像から、大きな切り抜き(global crop)2 枚と小さな切り抜き(local crop)数枚を作る(multi-crop)1
- 先生には大きな切り抜きだけ、生徒には全部を見せる。生徒は「一部しか見ていなくても、全体を見た先生と同じ出力を出す」ように学習する(局所→全体の対応)1
- 先生は別途学習するのではなく、生徒の重みの指数移動平均(EMA、モメンタムエンコーダ)で作る1
- 全部同じ出力になってしまう崩壊(collapse)を防ぐため、先生の出力にセンタリングとシャープニングをかける1
何がすごかったのか
- 自己教師ありで学習した ViT の注意マップに、教えていないのに物体のセグメンテーションに相当する情報がはっきり現れた。教師あり ViT や CNN ではここまで明確には出ない1
- 特徴がそのまま優れた k-NN 分類器になり、小型 ViT で ImageNet top-1 78.3%(k-NN)、ViT-Base で 80.1%(線形評価)を達成した1
- 学習データは ImageNet(ラベルは使わない)1
ひとことで言うと、ラベルなしでもここまで意味のある特徴が学べることを示した原点である。ただし学習データ・モデル規模は小さく、現在の実用では v2 / v3 が使われることが多い。
DINOv2(2023)── そのまま使える汎用特徴の確立
何が変わったか
DINOv2 は 2023 年 4 月公開2。主な変更点は次の 3 つ。
| 観点 | 内容 |
|---|---|
| 学習方法 | DINO の損失(画像単位)に、iBOT の損失(マスクしたパッチを当てる、パッチ単位)を組み合わせ、SwAV 由来の Sinkhorn-Knopp センタリングや、特徴を散らばらせる KoLeo 正則化を追加2 |
| データ | ラベルもテキストも使わず、画像の類似度だけで大量の未整理画像から選別した LVD-142M(1.42 億枚)を自動構築2 |
| モデル | 最大 ViT-g/14(約 11 億パラメータ)を学習し、そこから ViT-S / B / L を蒸留220 |
パッチ単位の損失が加わったことで、DINO より密な特徴が大幅に強化された。
モデル一覧(公式リポジトリ)
| モデル | パラメータ数 | パッチサイズ |
|---|---|---|
| ViT-S/14 distilled | 21M | 14 |
| ViT-B/14 distilled | 86M | 14 |
| ViT-L/14 distilled | 300M | 14 |
| ViT-g/14 | 1,100M | 14 |
それぞれに with registers 版もある20。
レジスタ(registers)という追加改良
2023 年 9 月、同じ FAIR のチームが、ViT の特徴マップには、背景の情報量が少ない場所に異常にノルムの大きいトークンが出る(アーティファクト)ことを報告した9。モデルが内部計算のために背景パッチをメモ用紙として流用していたのが原因で、専用の追加トークン(レジスタ)を入力に足すとこの問題が消え、特徴マップや注意マップがきれいになる9。DINOv2 にはレジスタ付きの重みが追加配布されている20。
実務上は、パッチ特徴を使う(セグメンテーション、異常検知など)なら、DINOv2 は _reg 付きモデルを選ぶほうが無難である。
DINOv2 の影響
DINOv2 は凍結したまま多くのタスクで使える初めての本格的な自己教師ありモデルで、オープンな CLIP 系モデルに匹敵または上回る結果を出した3。このため、後述するように深度推定(Depth Anything)、3D 再構成(VGGT)、ロボット(OpenVLA)、病理(UNI)など、多数のモデルの「目」として組み込まれた。
DINOv3(2025)── 7B 規模と、凍結のまま SOTA
概要
DINOv3 は 2025 年 8 月 14 日に公開4。DINOv2 比でモデルは約 7 倍、データは約 12 倍である4。
| 観点 | DINOv2 | DINOv3 |
|---|---|---|
| 最大モデル | ViT-g/14(1.1B) | ViT-7B/16(約 6.7B)5 |
| 学習データ | LVD-142M | LVD-1689M(約 17 億枚)。Instagram の公開投稿 約 170 億枚から自動選別3 |
| パッチサイズ | 14 | 163 |
| 位置埋め込み | 学習型 | axial RoPE(解像度変化に強い)3 |
| 学習スケジュール | コサインスケジュール | 定数スケジュールで 100 万イテレーション(いつまで学習するか事前に決めなくてよい)3 |
| 密な特徴の劣化対策 | ― | Gram anchoring3 |
| テキスト連携 | dino.txt(後追い) | dino.txt を同梱5 |
| 派生 | ― | 衛星画像版(SAT-493M)、ConvNeXt 版5 |
Gram anchoring ── DINOv3 の中核技術
DINOv2 の手法をそのまま大規模化すると、長く学習するほど画像全体の性能は上がるのに、パッチ特徴(密な特徴)は劣化するという問題が起きた。ViT-Large(300M)より大きいモデルを長く学習すると顕著になる3。
原因として、CLS トークンとパッチ出力のコサイン類似度が学習とともに上がり、パッチ特徴の局所性(その場所らしさ)が薄れていくことが観察された3。
Gram anchoring はこれを次のように解決する3。
- Gram 行列、つまり画像内の全パッチ同士の類似度(内積)を並べた行列を考える
- 学習初期の、パッチ特徴がまだきれいな時点のモデルを Gram 先生として用意する
- 生徒の Gram 行列が Gram 先生の Gram 行列に近づくように損失をかける
特徴そのものではなく、パッチ同士の類似関係の構造だけを固定するので、特徴自体は自由に改善しつつ、局所性は保たれる。論文では、劣化がかなり進んだ後から適用しても特徴が修復されたと報告している3。
モデルファミリー
7B は重いため、7B を先生として小型モデルへ蒸留したファミリーが配布されている。ViT-L は 7B に近い性能を持つとされる35。
| 系統 | モデル | パラメータ数 | 学習データ |
|---|---|---|---|
| ViT | ViT-S/16 | 21M | LVD-1689M |
| ViT | ViT-S+/16 | 29M | LVD-1689M |
| ViT | ViT-B/16 | 86M | LVD-1689M |
| ViT | ViT-L/16 | 300M | LVD-1689M |
| ViT | ViT-H+/16 | 840M | LVD-1689M |
| ViT | ViT-7B/16 | 6,716M | LVD-1689M |
| ConvNeXt | Tiny / Small / Base / Large | 29M / 50M / 89M / 198M | LVD-1689M |
| ViT(衛星) | ViT-L/16, ViT-7B/16 | 300M / 6,716M | SAT-493M(MAXAR 衛星画像) |
(出典: 公式リポジトリ README5、Meta ブログ4)
ConvNeXt 版は CNN なので、エッジデバイスや CNN 前提の既存パイプラインに組み込みやすい4。
主な性能
- 凍結したバックボーンで COCO 物体検出 mAP 66.1、ADE20k セグメンテーション mIoU 63.0。専用にファインチューニングしたパイプラインを上回る3
- 密な特徴の評価(線形プローブでのセグメンテーション)で、自己教師ありの比較対象を 6 mIoU 以上、CLIP 系(弱教師あり)を 13 mIoU 以上上回る3
- 画像分類では SigLIP 2 や Perception Encoder など最新の CLIP 系に匹敵する。大差で勝つのは密なタスクのほう34
- 動画で学習していないのに、パッチ特徴の類似度だけで動画内の物体を追跡できる(DAVIS で DINOv2 比 +6.7 ポイント)3
ただしベンチマークの数値は評価条件に強く依存する。COCO 66.1 は 7B バックボーンに大型の検出デコーダを載せた結果であり、ViT-S / B に簡易ヘッドを載せて同等になるわけではない。また、分類で CLIP 系に匹敵するというのは Meta の主張で、タスクやデータによっては CLIP 系のほうが良いこともある。
2026 年時点の動き
公式リポジトリの更新履歴5によると、公開後も周辺整備が続いている。
| 日付 | 内容 |
|---|---|
| 2025-08-29 | Hugging Face Transformers 4.56.0 以降で正式対応 |
| 2025-09-17 | timm 1.0.20 以降で対応 |
| 2025-10-13 | セグメンテーション・深度推定の線形プローブコード公開 |
| 2025-11-20 | ConvNeXt への蒸留コード公開 |
| 2026-03-10 | DINOv3 ベースの樹冠高マップ CHMv2 のモデルと推論コード公開 |
| 2026-06-12 | メタデータ(撮影場所・時刻などの付帯情報)でラベルなしに DINOv3 を専門領域へ適応させる FINO の学習コード公開(論文は NeurIPS 2026 採択)19 |
FINO は公開から日が浅く、第三者による追試はまだ限られる。
3 世代の比較まとめ
| DINO | DINOv2 | DINOv3 | |
|---|---|---|---|
| 公開 | 2021-04 | 2023-04 | 2025-08 |
| 学習データ | ImageNet(約 128 万枚、ラベル不使用) | LVD-142M | LVD-1689M / SAT-493M |
| 最大モデル | ViT-B 程度 | ViT-g(1.1B) | ViT-7B(6.7B) |
| 学習の柱 | 自己蒸留(画像単位) | 自己蒸留+マスクパッチ予測 | v2 + Gram anchoring + 高解像度適応 |
| 強み | 注意マップに物体形状が出る | 凍結のまま多タスクで強い | 密な特徴が特に強く、高解像度でもきれい |
| ライセンス | Apache 2.0 | Apache 2.0 | DINOv3 License |
| 今から使うなら | 学習・教材用途 | 既存エコシステムが豊富 | 新規開発の第一候補 |
紛らわしい DINO に注意
よくある混乱が、Grounding DINO や DINO-DETR は DINOv2 の仲間なのか、というもの。答えは別物で、名前が同じだけで作者も目的も違う。
| 名前 | 正体 | DINO(Meta)との関係 |
|---|---|---|
| DINO(DETR with Improved deNoising anchOr boxes, 2022) | IDEA Research などによる物体検出器(DETR の改良版)10 | なし(頭字語が偶然同じ) |
| Grounding DINO(2023) | 上の検出器 DINO にテキストを組み合わせて、「赤い車」のような言葉で任意の物体を検出できるようにしたオープンセット検出器11 | なし |
| Grounded-SAM など | Grounding DINO で箱を出し、SAM でマスクを切る組み合わせ | なし(Grounding DINO 側) |
DINO で物体検出、という記事を読むときは、どちらの DINO かを確認するとよい。この記事の DINO / DINOv2 / DINOv3 は、Meta の自己教師ありバックボーンのほうである。
何と組み合わせると、どんな方面に使えるのか
DINO 系は「目」にあたる部品なので、何を後ろにつなぐかで用途が決まる。以下、組み合わせのパターン別に整理する。
全体マップ
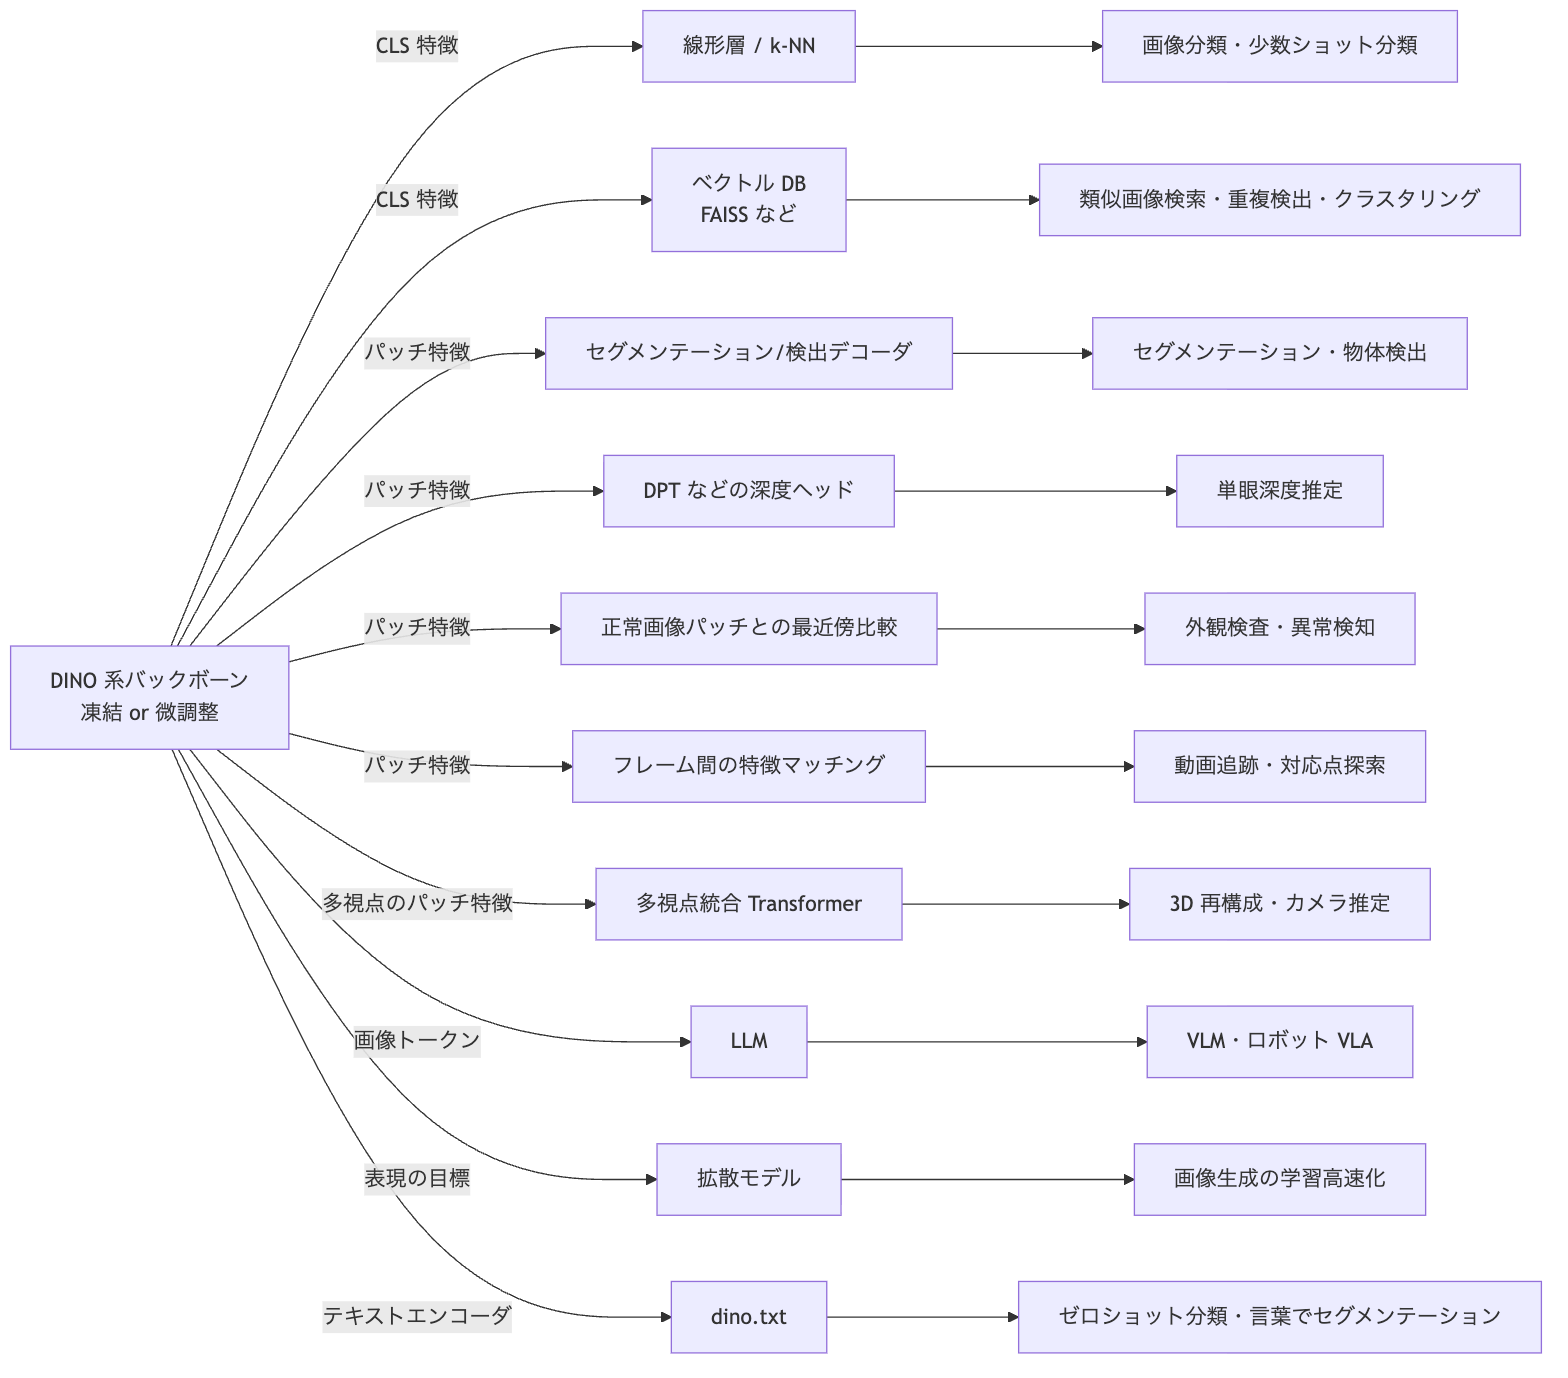
同じ内容を表にすると次のとおり。
| # | DINO から取り出すもの | 後ろにつなぐもの | できること |
|---|---|---|---|
| 1 | CLS 特徴 | 線形層 / k-NN | 画像分類・少数ショット分類 |
| 2 | CLS 特徴 | ベクトル DB(FAISS など) | 類似画像検索・重複検出・クラスタリング |
| 3 | パッチ特徴 | セグメンテーション / 検出デコーダ | セグメンテーション・物体検出 |
| 4 | パッチ特徴 | DPT などの深度ヘッド | 単眼深度推定 |
| 5 | パッチ特徴 | 正常画像パッチとの最近傍比較 | 外観検査・異常検知 |
| 6 | パッチ特徴 | フレーム間の特徴マッチング | 動画追跡・対応点探索 |
| 7 | 多視点のパッチ特徴 | 多視点統合 Transformer | 3D 再構成・カメラ推定 |
| 8 | 画像トークン | LLM | VLM・ロボット VLA |
| 9 | 表現の目標 | 拡散モデル | 画像生成の学習高速化 |
| 10 | 画像特徴+テキストエンコーダ | dino.txt | ゼロショット分類・言葉でセグメンテーション |
パターン別の詳細
(1) 線形層・k-NN → 画像分類、少数ショット分類
- 組み合わせ: CLS 特徴 + ロジスティック回帰 / 線形層 / k-NN
- ポイント: 初代 DINO の時点で k-NN だけで ImageNet 78.3% に達しており1、v2 / v3 ではさらに強い。ラベル付き画像が数十〜数百枚しかない業務分類(製品カテゴリ、部品の種類など)で、まず試す価値が高い
(2) ベクトル DB → 類似画像検索、重複検出、データ整理
- 組み合わせ: CLS 特徴(または平均プーリングした特徴) + FAISS などの近傍検索
- ポイント: DINOv2 自身も、学習データ LVD-142M を作る際に FAISS で類似画像検索・重複除去を行っている2。DINOv3 はインスタンス検索(同じ建物・同じ美術品を探す)で DINOv2 を大きく上回る(Met で +10.8 ポイント)3
- 用途例: EC の類似商品検索、画像の重複・ニアデュープ除去、学習データのクラスタリングとバランス調整
(3) セグメンテーション / 物体検出デコーダ → 自動運転・地図・医用画像の領域分割
- 組み合わせ: パッチ特徴 + 線形ヘッド(簡易)/ Mask2Former・DETR 系デコーダ(本格)
- ポイント: DINOv3 は凍結したままヘッドを付けるだけで COCO 検出 66.1 mAP、ADE20k 63.0 mIoU3。Cityscapes(車載カメラ画像)でも線形プローブで 81.1 mIoU3。公式リポジトリには 7B 用の検出器・セグメンテーションヘッドも配布されている5
- 注意: DINO 単体は物体の位置を出さない。検出したいなら検出デコーダの学習が必要になる。言葉で検出したいなら、Grounding DINO など別系統を検討する
(4) 深度ヘッド → 単眼深度推定(Depth Anything)
- 組み合わせ: DINOv2 エンコーダ + DPT デコーダ
- 代表例: Depth Anything V2。1 枚の画像から奥行きマップを出すモデルで、公式 README でも DINOv2-DPT アーキテクチャと明記されている1213。Apple Core ML や Transformers.js、ComfyUI でも利用でき、スマホ AR、写真の背景ぼかし、画像生成の深度条件付けなどで広く使われている13
- 注意: Depth Anything V2 は Small のみ Apache 2.0、Base / Large は CC-BY-NC-4.0(非商用)13
(5) 最近傍比較 → 外観検査・異常検知(製造業)
- 組み合わせ: パッチ特徴 + 正常品画像のパッチ特徴とのパッチ単位の最近傍距離
- 代表例: AnomalyDINO。DINOv2 のパッチ特徴を使い、追加学習なしで、正常品 1 枚〜数枚から異常を検出・位置特定する。MVTec-AD の 1 ショットで AUROC を 93.1% → 96.6% に改善した8
- ポイント: 不良品の画像を集めにくい製造現場と相性がよい。ヒートマップでどこが異常かも出せる
(6) 特徴マッチング → 動画の物体追跡、対応点探索
- 組み合わせ: フレーム間でパッチ特徴の類似度を計算し、ラベル(マスク)を伝播させる
- ポイント: DINOv3 は画像だけで学習したのに、この単純な方法で動画内の物体追跡ができる3。動画モデルを作るときのフレームエンコーダとしても有望とされる3
(7) 多視点統合 → 3D 再構成、カメラ姿勢推定(VGGT)
- 組み合わせ: 複数視点の画像を DINO 系でトークン化 + 視点間を統合する Transformer
- 代表例: VGGT(CVPR 2025)。1 枚〜数百枚の画像から、カメラパラメータ・深度マップ・点群・3D 点追跡を 1 秒未満で一括推定する7。DINOv2 で事前学習したバックボーンを使っており、DINOv3 論文では DINOv2 を DINOv3 ViT-L に差し替えて性能が上がったことが報告されている3
- 用途例: 写真からの 3D 復元、デジタルツイン、AR/VR のシーン理解
(8) LLM → VLM(画像を理解する LLM)、ロボット VLA
- 組み合わせ: DINO 系の画像トークン +(多くの場合 CLIP / SigLIP の特徴も) + LLM
- 代表例: OpenVLA。Llama 2 に、DINOv2 と SigLIP の特徴を融合した視覚エンコーダを組み合わせた 7B のロボット制御モデル(Vision-Language-Action)14
- なぜ併用するのか: SigLIP(CLIP 系)は「これは何か」という言葉と結びついた意味に強く、DINOv2 は「どこに・どんな形で」という空間情報に強い。ロボットが物を掴むには両方必要になる
- 実績: NASA JPL は DINOv2 を火星探査ロボットの開発に使い、少ない計算資源で複数の視覚タスクをこなしている4
(9) 拡散モデル → 画像生成の学習効率化(REPA)
- 組み合わせ: 拡散 Transformer(DiT / SiT)の中間表現を、DINOv2 の特徴に揃える正則化
- 代表例: REPA(ICLR 2025 Oral)。外部の事前学習済みエンコーダの表現に、拡散モデル内部の表現を合わせる手法で、SiT の学習が 17.5 倍以上高速化した15。公式実装の標準設定は DINOv2 エンコーダ(
dinov2-vit-bなど)16 - ポイント: DINO は生成はしないが、生成モデルに良い表現を教える先生として使われる
(10) テキストエンコーダ(dino.txt) → ゼロショット分類、言葉でのセグメンテーション
- 組み合わせ: DINOv3 ViT-L + 後付けで学習したテキストエンコーダ(dino.txt)
- ポイント: 公式に dino.txt のテキストエンコーダと、言葉を指定してセグメンテーションするオープン語彙セグメンテーションのノートブックが提供されている5。CLIP のようにテキストでも引きたいが、密な特徴は DINO の品質がほしい、という場合の選択肢になる
分野別の利用例
| 分野 | 組み合わせ・事例 |
|---|---|
| 衛星・環境モニタリング | DINOv3 衛星版(SAT-493M)+ 樹冠高推定ヘッド。WRI(世界資源研究所)が森林破壊の監視に利用し、ケニアのある地域で樹冠高の平均誤差が DINOv2 の 4.1m から 1.2m に改善4。2026 年には樹冠高マップ CHMv2 を公開5 |
| 医療・病理 | 大量の病理画像で学習した基盤モデル UNI(Mahmood Lab)が DINOv2 を用いて開発された1718。Meta も組織学・内視鏡・医用画像での活用を紹介している4 |
| 生物・顕微鏡 | DINOv2 リポジトリに細胞画像向けの Cell-DINO、X 線向けの XRay-DINO が追加されている(ただし重みは非商用ライセンス)20 |
| 製造(外観検査) | AnomalyDINO のようなパッチ最近傍による少数ショット異常検知8 |
| 自動運転・ロボット | セグメンテーション・深度推定・追跡を 1 回の推論で共有。OpenVLA のような VLA の視覚部314 |
| 3D / AR | Depth Anything(深度)、VGGT(多視点 3D)712 |
| 画像生成 | REPA による拡散モデルの学習高速化、Depth Anything の深度を ControlNet 等の条件に使う1315 |
| 小売・EC | 類似商品検索、商品画像の分類・重複除去(特定の公式事例ではなく、技術的に妥当な一般的用途として挙げている) |
ここに挙げたのは代表例で、網羅的な一覧ではない。
どの組み合わせを選ぶか
迷ったら、上から順に質問に答えていけばよい。
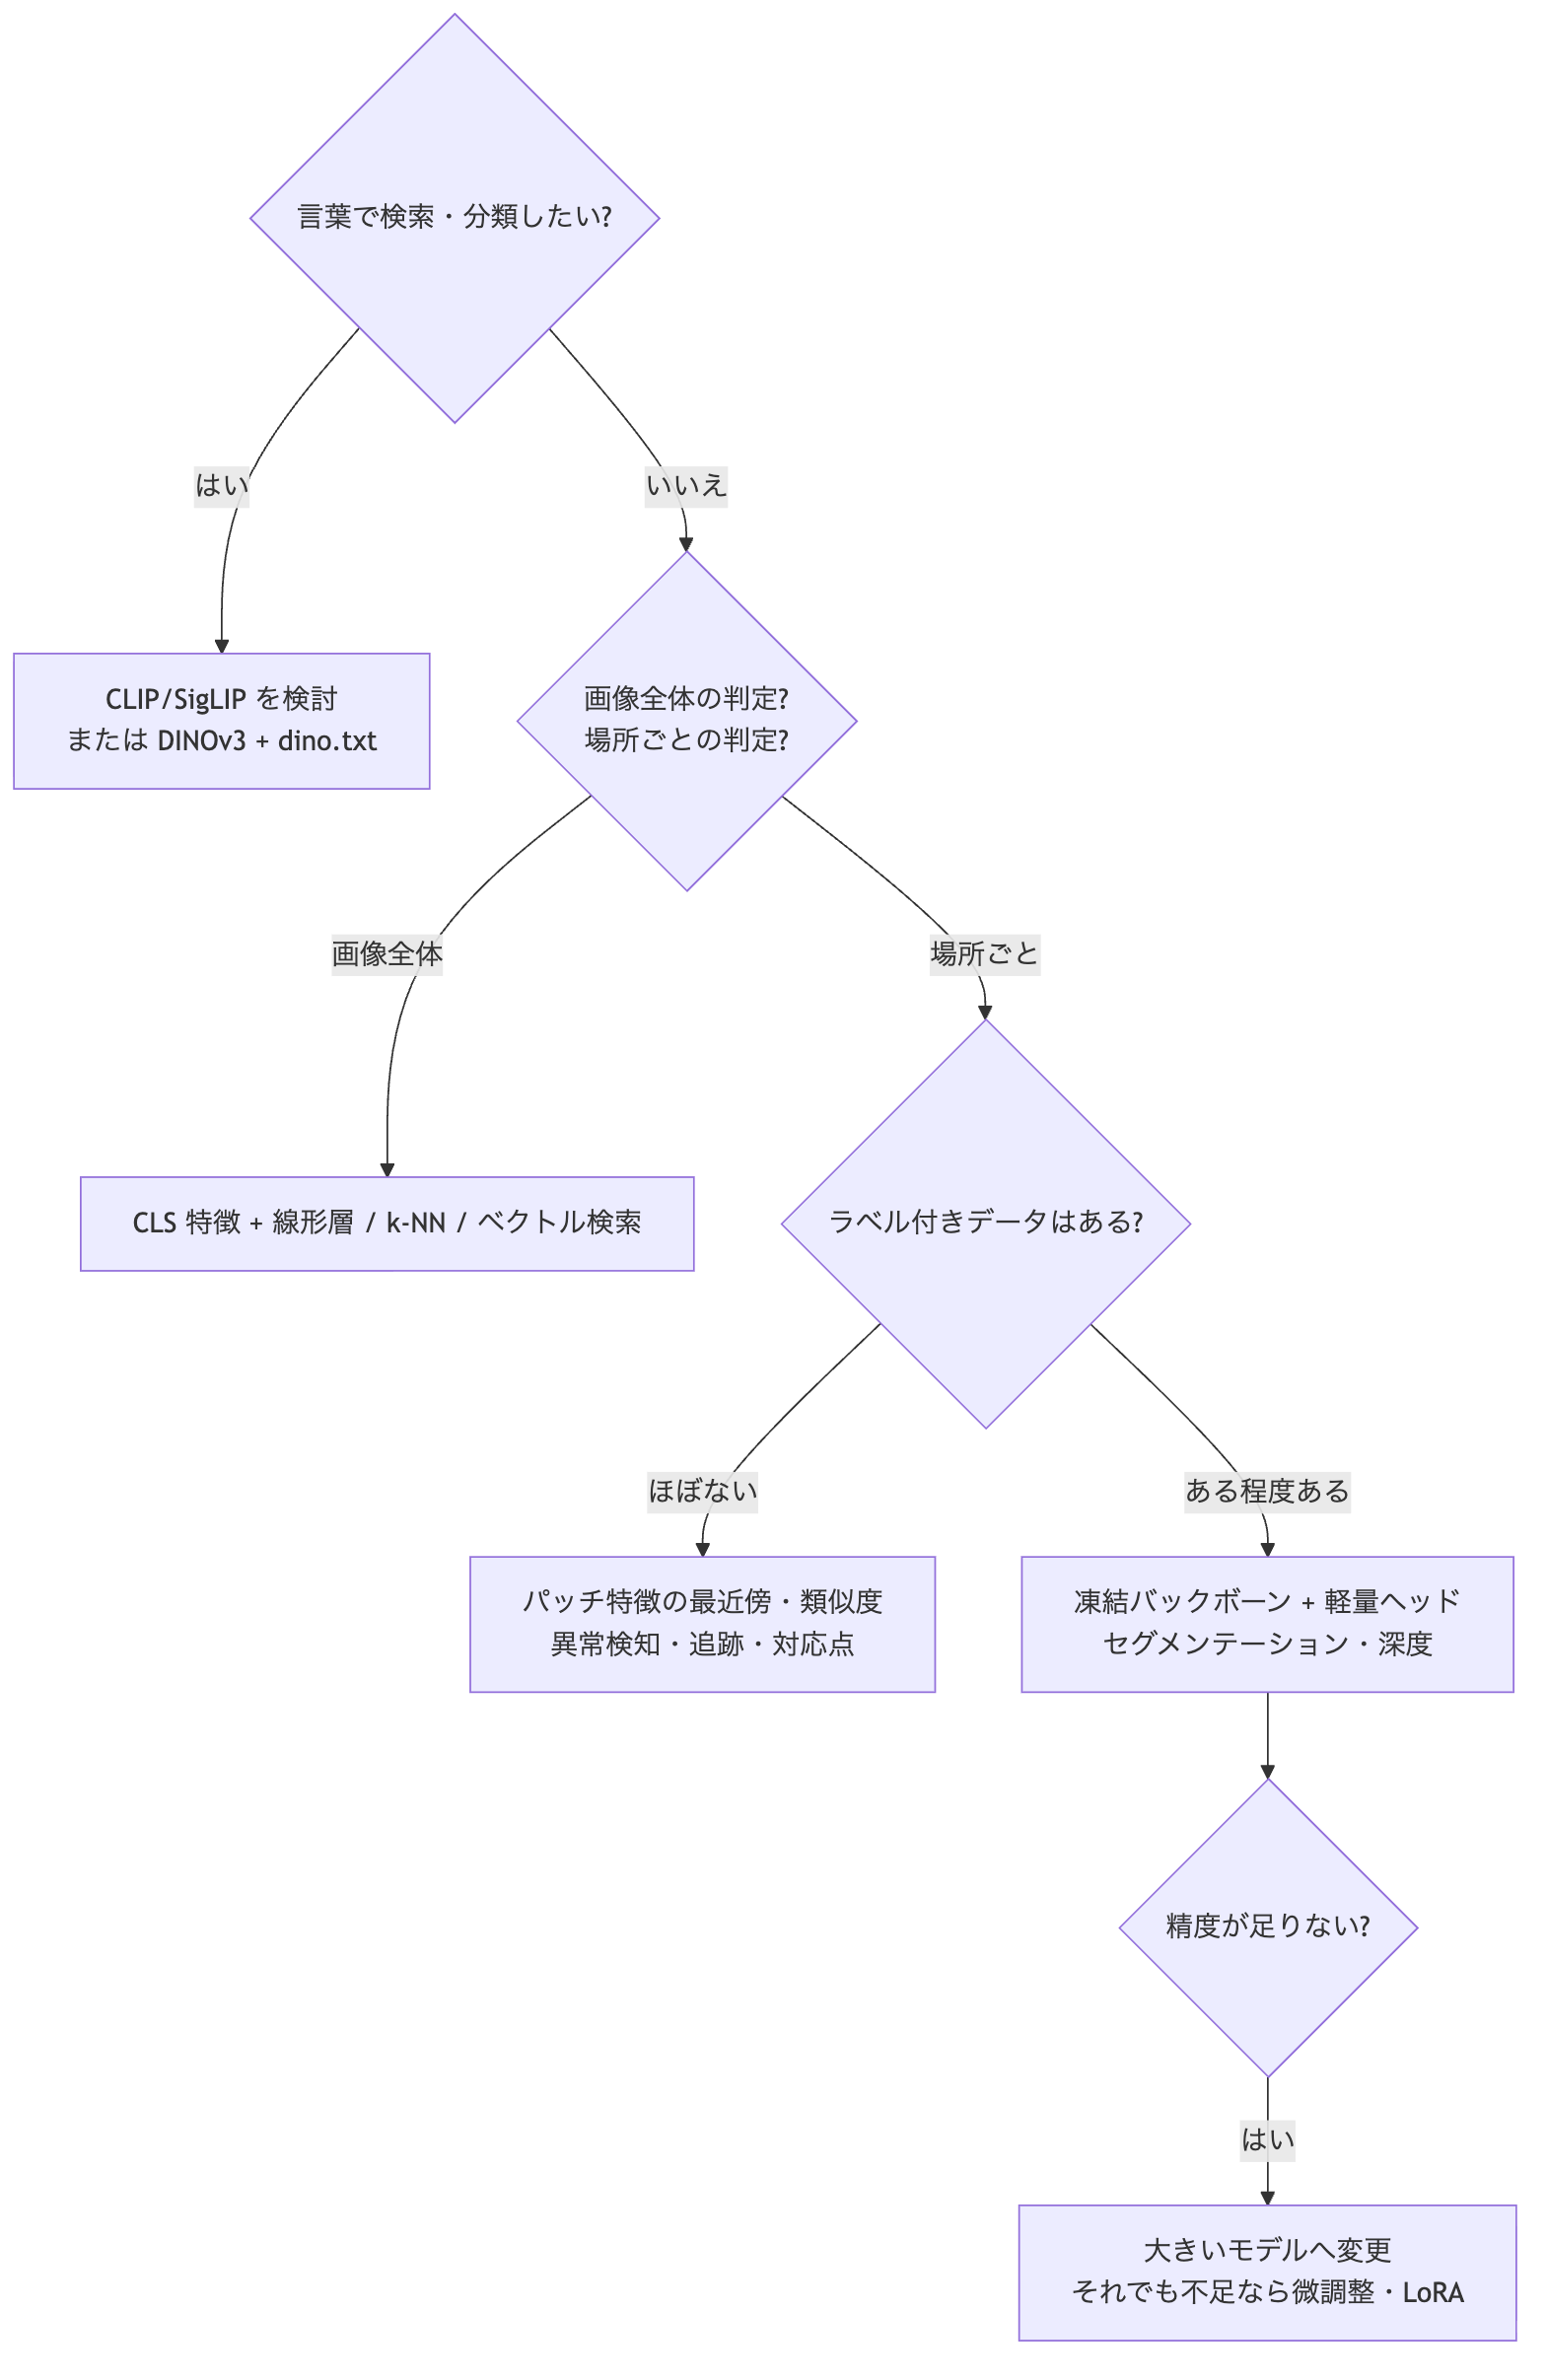
文字で書くと次のとおり。
- 言葉で検索・分類したい?
- はい → CLIP / SigLIP を検討する。または DINOv3 + dino.txt
- いいえ → 2 へ
- 画像全体を判定したい? 場所ごとに判定したい?
- 画像全体 → CLS 特徴 + 線形層 / k-NN / ベクトル検索
- 場所ごと → 3 へ
- ラベル付きデータはある?
- ほぼない → パッチ特徴の最近傍・類似度で解く(異常検知・追跡・対応点)
- ある程度ある → 凍結バックボーン + 軽量ヘッド(セグメンテーション・深度)。4 へ
- 精度が足りない?
- はい → 大きいモデルへ変更する。それでも不足なら微調整や LoRA
実際に使ってみる(DINOv3 / Hugging Face Transformers)
画像全体の特徴とパッチ特徴を取り出す
Transformers 4.56.0 以降で DINOv3 が使える5。Hugging Face 上のモデルは、利用規約への同意が必要になる場合がある。
import torchfrom transformers import AutoImageProcessor, AutoModelfrom transformers.image_utils import load_image
image = load_image("http://images.cocodataset.org/val2017/000000039769.jpg")
name = "facebook/dinov3-vits16-pretrain-lvd1689m"processor = AutoImageProcessor.from_pretrained(name)model = AutoModel.from_pretrained(name, device_map="auto")
inputs = processor(images=image, return_tensors="pt").to(model.device)with torch.inference_mode(): outputs = model(**inputs)
# 画像全体の特徴(分類・検索用)global_feat = outputs.pooler_output # (1, D)
# パッチ特徴(セグメンテーション・異常検知用)# ViT の出力は [CLS, レジスタ×N, パッチ...] の順に並ぶn_reg = model.config.num_register_tokenspatch_feat = outputs.last_hidden_state[:, 1 + n_reg:, :] # (1, パッチ数, D)中級者向けの注意点
| 項目 | 注意 |
|---|---|
| パッチサイズ | DINOv2 は 14、DINOv3 は 16。入力解像度はパッチサイズの倍数にする(例: v2 は 224・518、v3 は 256・512)。比較実験ではパッチ数を揃える(v2 の 448px と v3 の 512px がどちらも 1024 パッチ)3 |
| レジスタ | DINOv3 の ViT は 4 個のレジスタトークンを持つ3。パッチ特徴を取り出すときに CLS とレジスタを除外し忘れない |
| 解像度 | DINOv3 は高解像度適応の学習をしているため、解像度を上げるほど細かい特徴が得られる(4096×4096 でもきれいな特徴マップ)3。ただし計算量はパッチ数の 2 乗で増える |
| モデル選び | まず ViT-S / B で試し、足りなければ ViT-L。DINOv3 の ViT-L は 7B に近い性能3。7B は研究・データ生成用と割り切る |
| CNN が必要な場合 | DINOv3 ConvNeXt 版(Tiny 29M〜)を使う5 |
| 凍結か微調整か | まずは凍結+軽量ヘッド。凍結のほうが汎化性能を損ないにくく、1 回の推論を複数タスクで共有できる4。ドメインがかけ離れている(衛星・顕微鏡など)場合は、ドメイン画像での追加の自己教師あり学習(FINO など)や微調整を検討する19 |
| ドメイン | 衛星・航空画像なら DINOv3 の SAT-493M 版を先に試す5 |
| 読み込み方法 | Transformers、timm(1.0.20 以降)、PyTorch Hub のいずれでも可5 |
ライセンスの整理
| 対象 | ライセンス | 要点 |
|---|---|---|
| DINO(v1) | Apache 2.020 | 商用利用可 |
| DINOv2 本体(コード・重み) | Apache 2.020 | 商用利用可。ただし同リポジトリの XRay-DINO・Cell-DINO の重みは FAIR Noncommercial Research License(非商用) |
| DINOv3(コード・重み) | DINOv3 License56 | 商用利用可。再配布時はライセンス文書の同梱が必要。研究発表時は DINO 利用の明記が必要。ITAR 対象の活動や軍事・核・諜報・武器関連用途は禁止。制裁対象者は利用不可 |
| Depth Anything V2 | Small: Apache 2.0、Base/Large: CC-BY-NC-4.013 | 派生モデルは派生元と別のライセンスになっていることが多い |
DINOv2 ベースだから Apache 2.0、とは限らない。組み込む派生モデル自体のライセンスを必ず確認すること。また DINOv3 License には、Meta が予告なく変更できる条項(第 8 条)がある6。商用で使う前には最新版を確認したい。
まとめ
- DINO は Meta の自己教師あり画像エンコーダで、後ろに何をつなぐかで用途が決まる「目」である
- 初代 DINO が「ラベルなしでも物体の形が見える」ことを示し、DINOv2 が「凍結したまま使える汎用特徴」を確立し、DINOv3 が規模と Gram anchoring で密な特徴を一段引き上げた
- CLIP / SigLIP とは得意分野が違う。言葉なら CLIP 系、場所ごとの細かい特徴なら DINO 系で、両方要る場面では併用される
- Grounding DINO は別物。DINOv3 は独自ライセンス、派生モデルはさらに別ライセンスのことが多い
- 新しく始めるなら、DINOv3 の ViT-S / B を凍結して、軽量ヘッドか最近傍検索から試すのがよさそうである
RSNA の公開ノートブックで DINO がメインに据えられていたのも、おそらくこのあたりが理由だろう。ラベル付きの医用画像は少ないので、凍結しても強い特徴が出るバックボーンは、それだけで扱いやすい。
参考文献
- Caron et al., “Emerging Properties in Self-Supervised Vision Transformers”(DINO, ICCV 2021) https://arxiv.org/abs/2104.14294
- Oquab et al., “DINOv2: Learning Robust Visual Features without Supervision” https://arxiv.org/abs/2304.07193
- Siméoni et al., “DINOv3”(技術レポート) https://arxiv.org/abs/2508.10104
- Meta AI Blog, “DINOv3: Self-supervised learning for vision at unprecedented scale”(2025-08-14) https://ai.meta.com/blog/dinov3-self-supervised-vision-model/
- facebookresearch/dinov3(公式リポジトリ README・LICENSE.md) https://github.com/facebookresearch/dinov3
- DINOv3 License https://github.com/facebookresearch/dinov3/blob/main/LICENSE.md
- Wang et al., “VGGT: Visual Geometry Grounded Transformer”(CVPR 2025) https://arxiv.org/abs/2503.11651
- Damm et al., “AnomalyDINO: Boosting Patch-based Few-shot Anomaly Detection with DINOv2”(WACV 2025) https://arxiv.org/abs/2405.14529
- Darcet et al., “Vision Transformers Need Registers” https://arxiv.org/abs/2309.16588
- Zhang et al., “DINO: DETR with Improved DeNoising Anchor Boxes for End-to-End Object Detection” https://arxiv.org/abs/2203.03605
- Liu et al., “Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection” https://arxiv.org/abs/2303.05499
- Yang et al., “Depth Anything V2”(NeurIPS 2024) https://arxiv.org/abs/2406.09414
- Depth Anything V2 公式リポジトリ README https://github.com/DepthAnything/Depth-Anything-V2
- Kim et al., “OpenVLA: An Open-Source Vision-Language-Action Model” https://arxiv.org/abs/2406.09246
- Yu et al., “Representation Alignment for Generation: Training Diffusion Transformers Is Easier Than You Think”(REPA, ICLR 2025) https://arxiv.org/abs/2410.06940
- REPA 公式リポジトリ https://github.com/sihyun-yu/REPA
- UNI 公式リポジトリ(Mahmood Lab) https://github.com/mahmoodlab/UNI
- Meta AI Blog, “Mahmood Lab: human pathology with DINOv2” https://ai.meta.com/blog/mahmood-lab-human-pathology-dinov2/
- Gardès et al., “Who Needs Labels? Adapting Vision Foundation Models With the Metadata You Already Have”(FINO) https://www.alphaxiv.org/abs/2606.05107
- facebookresearch/dinov2(公式リポジトリ README・LICENSE)/ facebookresearch/dino(LICENSE) https://github.com/facebookresearch/dinov2 https://github.com/facebookresearch/dino