


この記事についてClaude(Anthropic)との共同編集により作成されました。
要約
- 全二重音声対話モデルは、相手の声を聞きながら同時に話せるモデルである。相づち、割り込み、言いよどみへの反応を、発話の区切りを待たずに処理する
- 作り方は、VAD・音声認識・LLM・音声合成をつないでターン管理を後付けする方式と、1 つのモデルが音声トークンを直接入出力する方式の 2 つ。後者の代表が Kyutai の Moshi である
- 2025 年のベンチマークでは「速いモデルは空気が読めず、空気が読めるモデルは遅い」状態だった。2026 年秋には GPT-Live と Shizuku-Duplex がその差を縮めたと発表したが、開発元の自己評価である
- 2026 年 11 月には日本語の全二重が動き、手元で動く Apache 2.0 の Haru-4B も出た。一方で、第三者への話しかけや背景の声を自分宛てと誤認しない割合は、最高でも 32% で、多くのモデルは 2 割以下にとどまる
- 自分の見立てでは、ローカルの全二重が一番効くのは災害現場である。ネットが無く、声が重なり、テキストを打つ余裕もない。ネットに載せたくない会話もローカルの用途になりうるが、それは悪用を止められないことの裏返しでもある。発展は楽しみだが、自分の普段の作業では直近の使い道はあまりない
きっかけ
2026 年 11 月、日本語の全二重音声モデルが立て続けに出た。8 日に Shizuku AI の Shizuku-Duplex、13 日に higurashi の Haru-4B である。7 月には OpenAI も ChatGPT Voice に全二重の GPT-Live を入れている。
「全二重」という言葉は、DeepSeek の Super-agent 記事を図解したとき にも出てきた。あちらはツールの完了を待たずに話を聞くという、エージェント設計の話だった。音声モデルの全二重は何を指していて、どう作られているのか。入門から調べ直し、図にして整理した。最後に、これが役に立つ場面を自分なりに考える。
全二重とは:人間の会話の「重なり」を扱えること
通信の用語で、トランシーバーのように片方ずつしか送れないのが半二重(half-duplex)、電話のように両方向が同時に流れるのが全二重(full-duplex)である。従来の音声アシスタントは半二重で、ユーザーが話し終わるのを待ってから応答を返す。
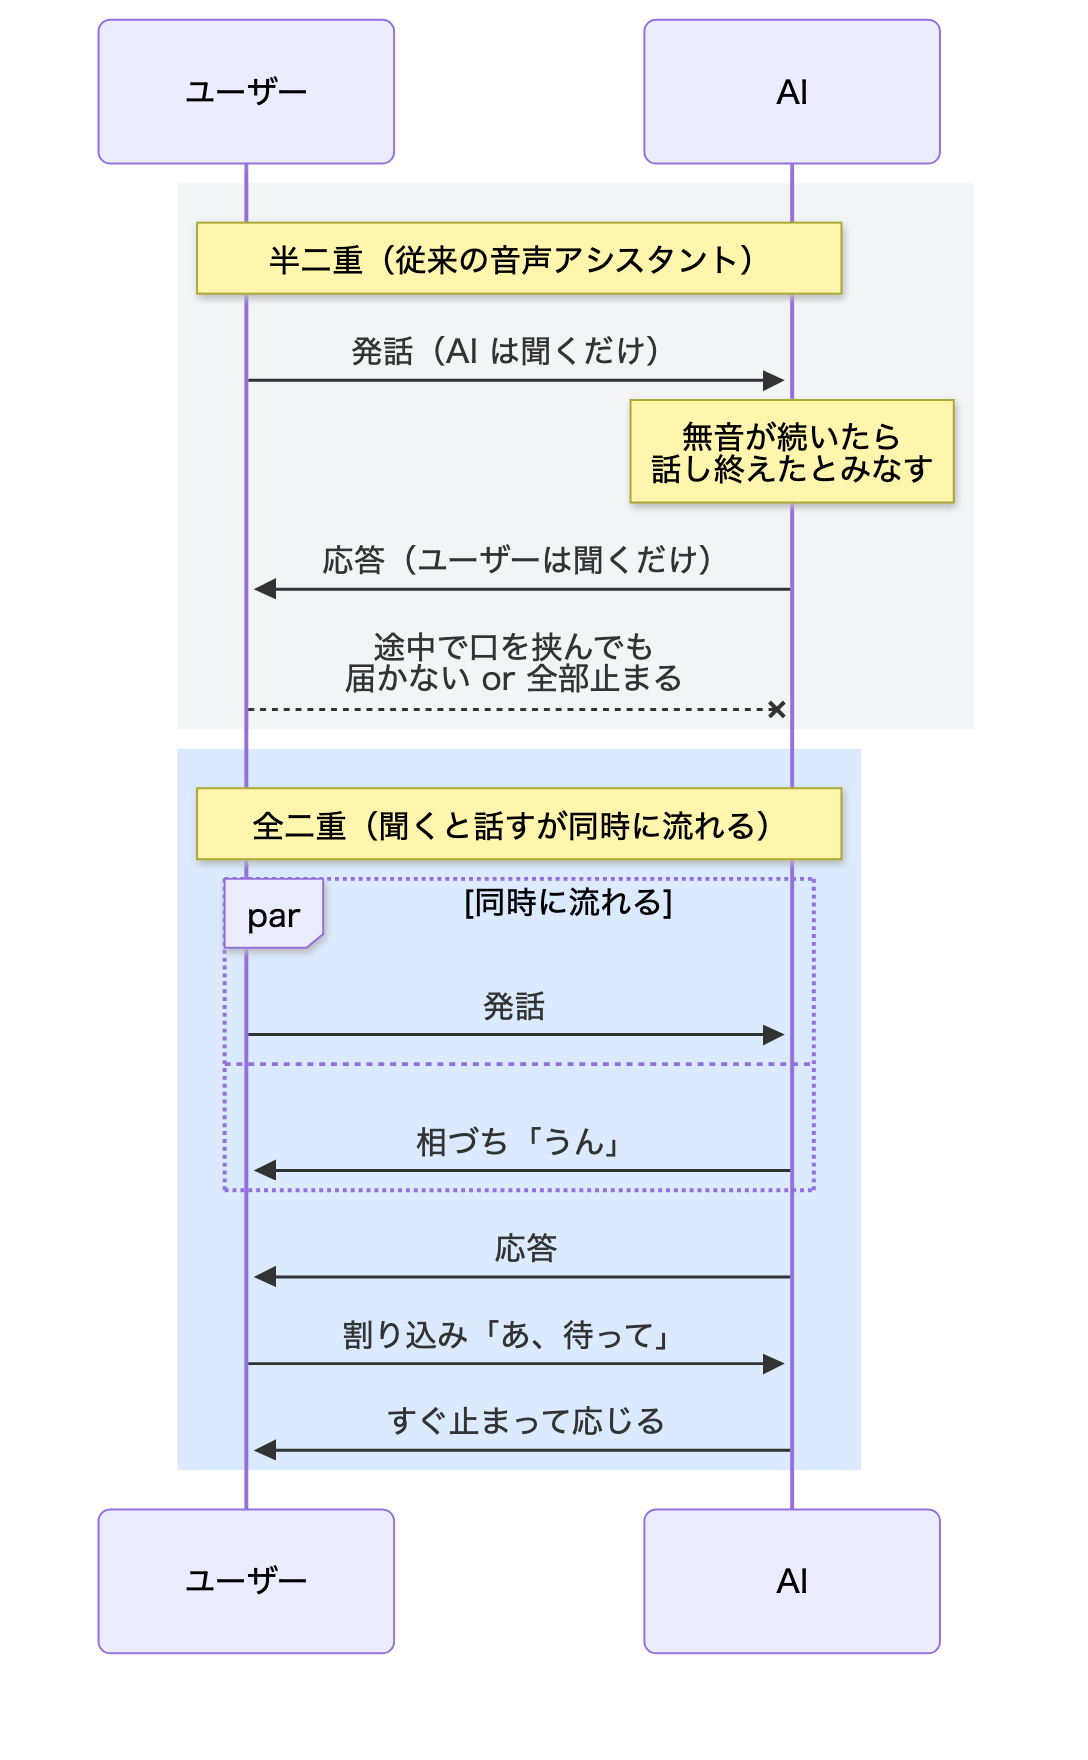
人間の会話は半二重ではない。Moshi の論文によると、自然な会話で応答するまでの平均間隔は約 230 ms で1、発話の終わりを待ってから考え始めていては間に合わない。聞き手は「うん」「なるほど」と相づちを打ち、話し手は割り込まれれば話を止める。
Full-Duplex-Bench は、これを次の 4 つの振る舞いに分けて測っている13。
| 振る舞い | 求められること |
|---|---|
| ポーズ処理 | ユーザーが言葉の途中で黙っても、割り込まずに待つ |
| 相づち | 発話を奪わずに、適切なタイミングで短い反応を返す |
| ターン交代 | ユーザーが話し終えたら素早く話し始める |
| 割り込み対応 | ユーザーが割り込んだら話をやめ、新しい発言に合った応答をする |
難しいのは、ポーズ処理とターン交代が同じ入力に正反対の反応を求めることだ。
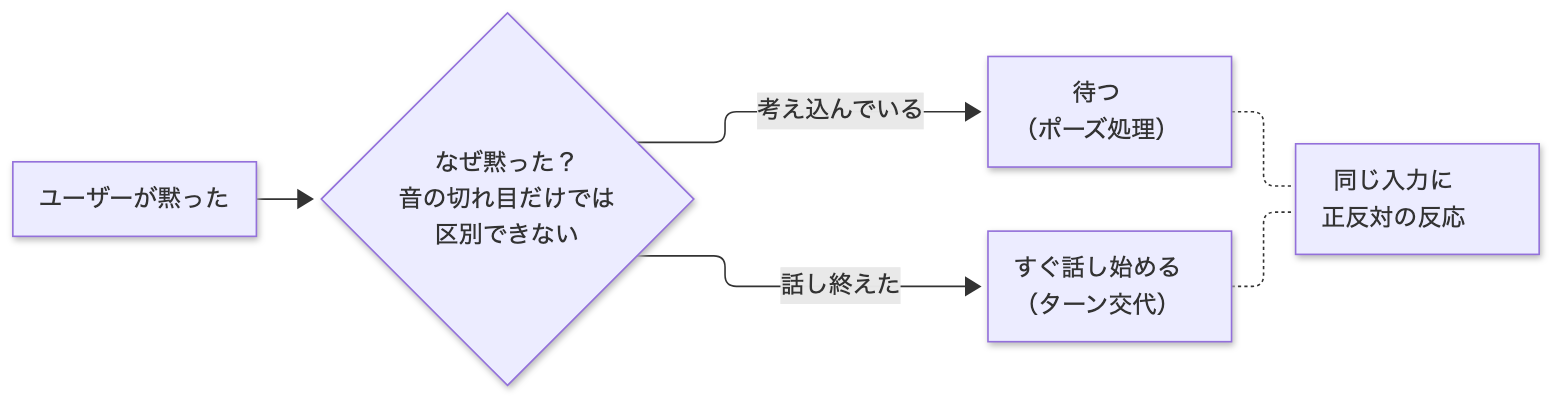
音の切れ目だけでは区別できず、文の意味まで見る必要がある。全二重が難しい理由はここにある。
作り方は二通り
Chen と Yu のサーベイは、全二重モデルを Engineered Synchronization と Learned Synchronization に分けている15。
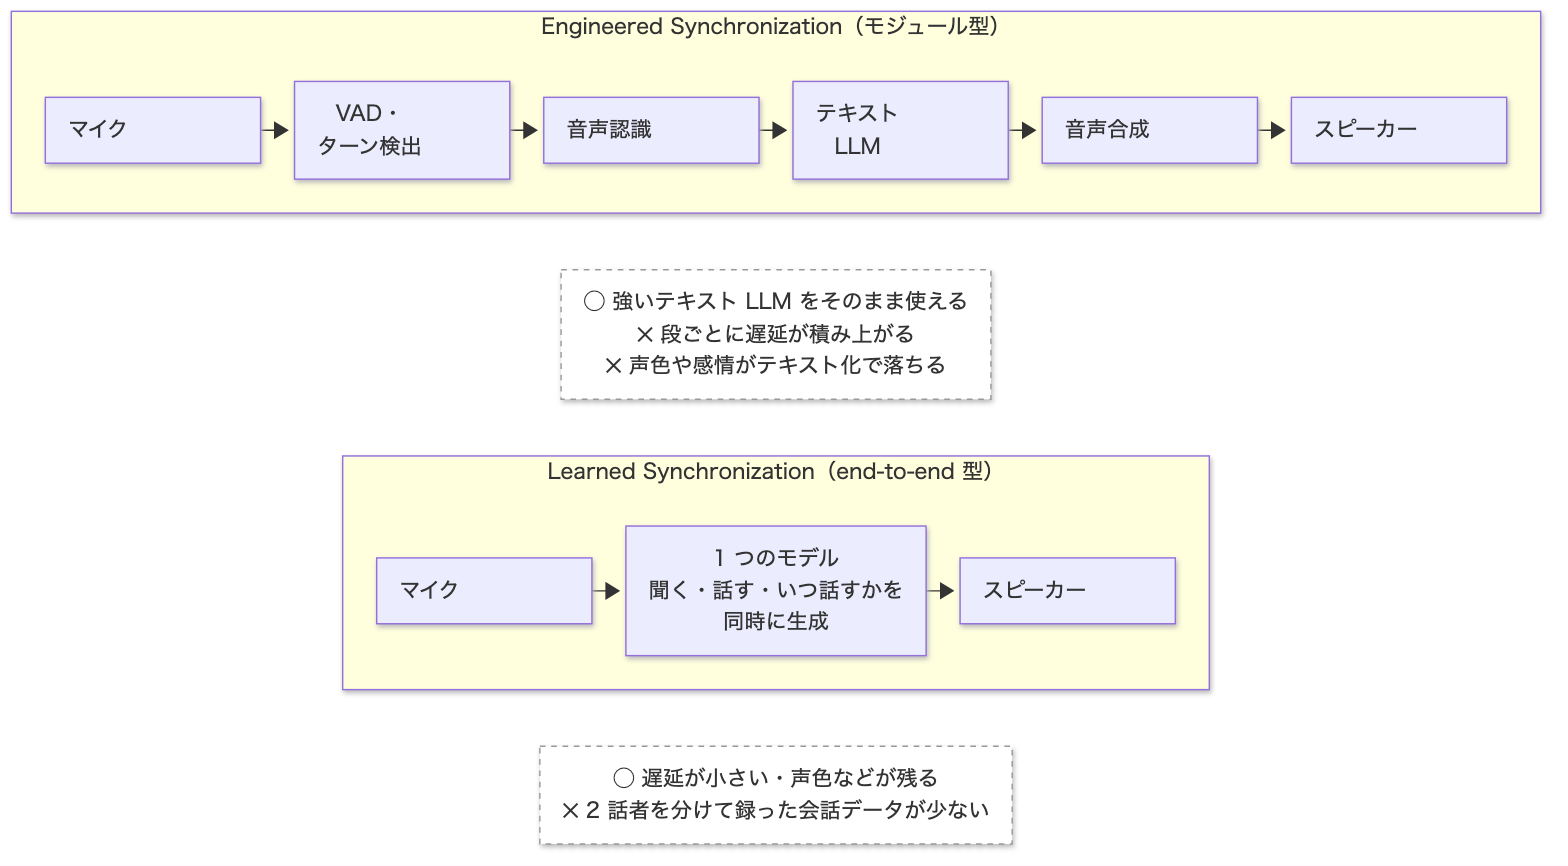
- モジュール型(Engineered):VAD やターン検出器などの部品で「いつ話すか」を決め、中身は音声認識、LLM、音声合成のパイプラインで作る。既存の高性能なテキスト LLM をそのまま使えるのが利点で、段数が増えるぶん遅延が積み上がるのが欠点である
- end-to-end 型(Learned):ユーザーの音声とモデル自身の音声を 1 つのモデルが同時に読み書きし、「いつ話すか」もデータから学習する。Moshi、SyncLLM、OmniFlatten などがここに入る145
商用 API のドキュメントに書かれているのは、VAD によるターン検出である。OpenAI Realtime API は、無音の長さで区切る server_vad と、発話内容から話し終えたかを判定する semantic_vad を提供する18。Gemini Live API も既定で VAD を使い、ユーザーの割り込みを検出すると生成中の応答を破棄して interrupted を通知する19。内部のモデル構造は公開されておらず、どちらの型に当たるかはドキュメントからは判断できない。
一方、OpenAI が 2026 年 7 月 8 日に ChatGPT Voice へ導入した GPT-Live-1 は、全二重として発表されている22。報道によると、音声を受け取りながら発話を生成し、「聞き続ける、話す、止まる」を毎秒何度も判断する。発表時点では API 提供はなかった。
用語の揺れにも注意したい。Lu らのサーベイは、十数個のシステムが「full-duplex」を名乗っているが、指している能力はばらばらだと指摘する16。製品紹介の「全二重対応」は、割り込みで止まれるだけの意味のことも、同時発話を生成できる意味のこともある。
Moshi を分解すると仕組みがわかる
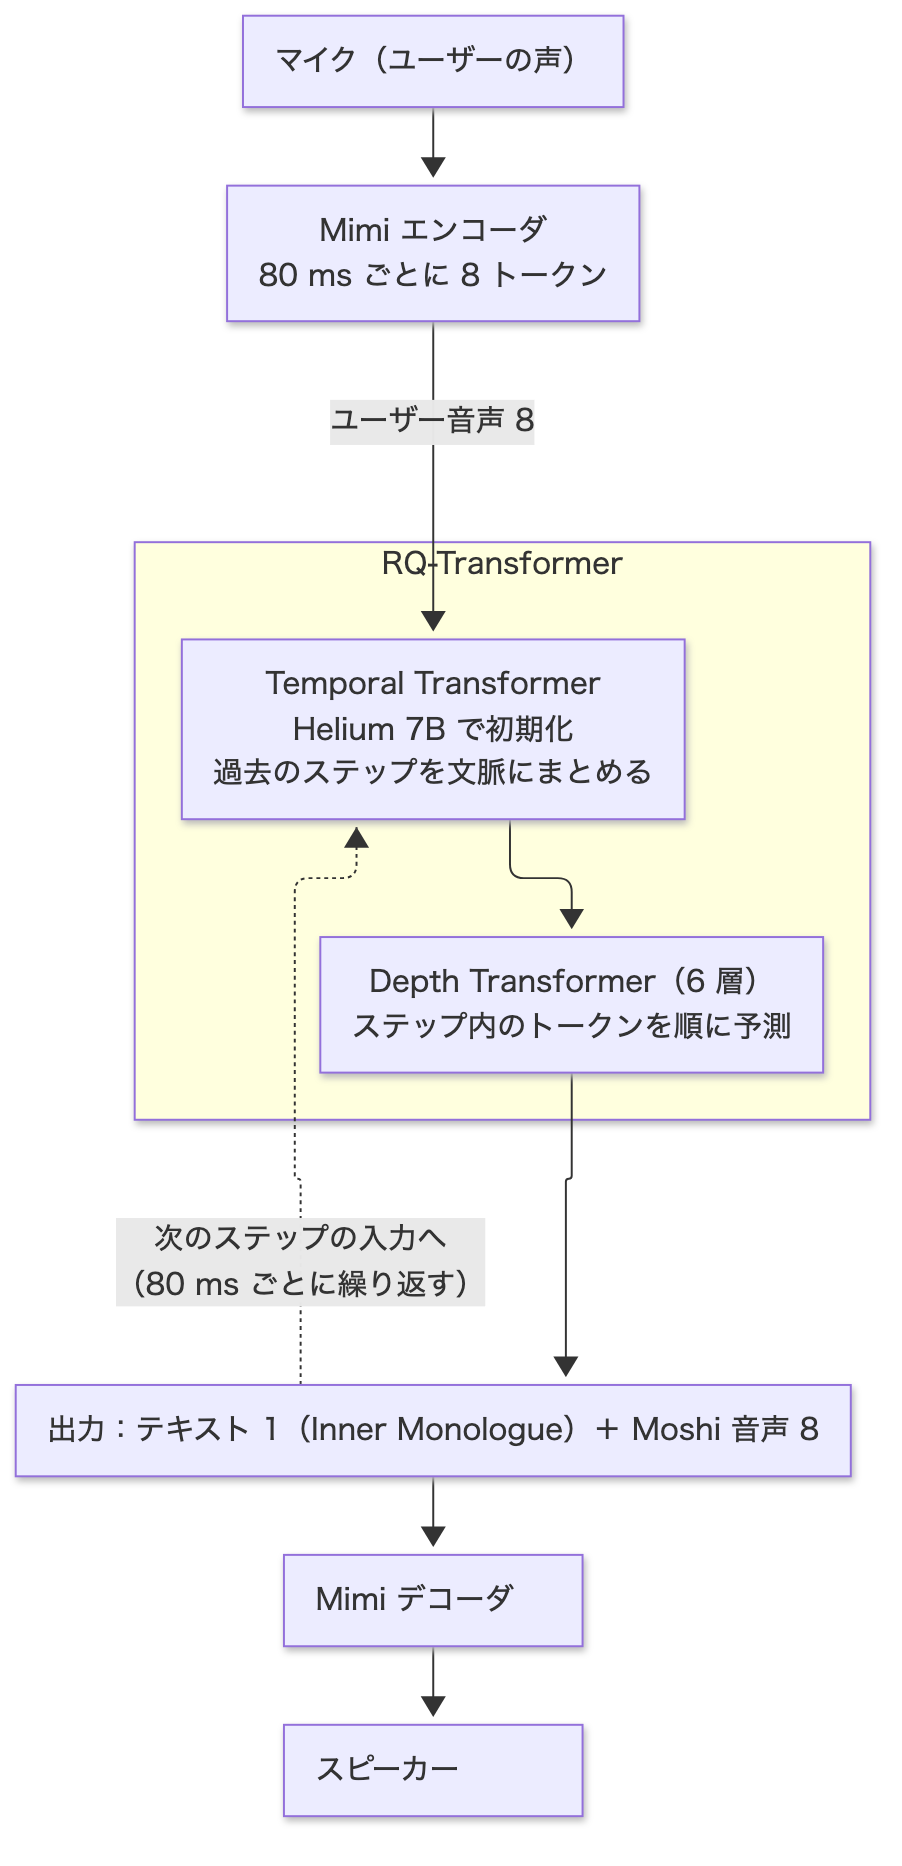
Moshi は Kyutai が 2024 年 9 月に公開した、音声とテキストの基盤モデルである1。重みは CC-BY 4.0 で公開され、Mac 向けの MLX 版もある2。全体の流れは次のとおり。
音声をトークンにする Mimi
Mimi は音声を 80 ms ごとのフレーム(12.5 Hz)に区切り、1 フレームを 8 個のトークンで表すストリーミング用コーデックである1。1 個目は意味寄りの情報を、残り 7 個は音色などの音響情報を担う。ビットレートは 1.1 kbps。テキスト LLM が単語をトークンで扱うのと同じように、音声を離散トークンの列として扱えるようにする部品である。
2 本の音声と 1 本のテキストを並列に生成する
Moshi は 80 ms の 1 ステップごとに、次の 17 個のトークンをまとめてモデル化する1。
時刻 → t=1 t=2 t=3 t=4 ...テキスト PAD こん PAD にち ← Moshi 自身の「内なる独白」1本Moshi 音声 [8トークン] [8トークン] ... ← 自分の声ユーザー音声 [8トークン] [8トークン] ... ← 相手の声(常に入力され続ける)ユーザー側のストリームが止まらずに流れ込み、Moshi 側も無音を含めて毎ステップ何かを出力し続ける。これが全二重の正体である。話す、黙る、相づちを打つ、話をやめる、の区別は、どのトークンを出すかの選択に帰着する。論文の評価では、質問の音声トークンをユーザーストリームに挿入して対話を模擬している1。
この 17 本をまとめて扱うために、RQ-Transformer という二段構成を使う1。
- Temporal Transformer:時間方向に過去のステップをまとめて文脈ベクトルを作る。7B パラメータのテキスト LLM「Helium」で初期化されており、会話の中身を考える役を担う
- Depth Transformer:各ステップの中で、トークンを 1 個ずつ順に予測する小さなモデル(6 層)
Inner Monologue:話す前に自分のセリフを文字で考える
Moshi は自分の音声トークンの前に、時刻をそろえたテキストトークンを出力する。論文はこれを Inner Monologue(内なる独白)と呼ぶ1。単語と単語の間は PAD という空白トークンで埋めるため、英語の会話ではテキスト列の約 65% が PAD になる。テキストを経由することで、音声だけで学習したモデルより発話内容の言語的な質と事実性が上がると報告されている。
意味トークンに対して音響トークンを 1〜2 ステップ遅らせて生成する工夫(acoustic delay)もある1。理論遅延 160 ms は、Mimi のフレーム 80 ms と音響の遅延 80 ms の合計である2。実際の遅延は約 200 ms とされる1。
学習データは、教師なしの音声 700 万時間で事前学習し、2 話者の電話会話コーパス Fisher(2,000 時間)でターン交代を学ばせ、2 万時間超の合成音声対話で指示追従を仕上げる、という段階を踏んでいる1。2 話者が別チャンネルに録音された会話データは少なく、合成データでそれを補う構図は後続モデルにも共通している。
一列に並べる方式もある
ストリームを並列に持たず、一本の系列に交互に並べる方式もある。OmniFlatten は、ユーザー音声、モデルのテキスト、モデルの音声を小さなチャンクに切って交互に並べる5。テキストは 2 トークン、音声は 10 トークンずつで、ベースは Qwen2-0.5B である。通常の GPT 型 LLM のアーキテクチャを変えずに済むのが利点だ。SyncLLM は、Llama3-8b に「現実の時計と同期して動く」仕組みを加えたモデルである4。
並列型は時間の対応が構造に組み込まれる代わりに専用アーキテクチャが要る。交互型は既存 LLM を流用しやすい代わりに、チャンクの切り方が遅延と精度を左右する。
主なモデルの系譜
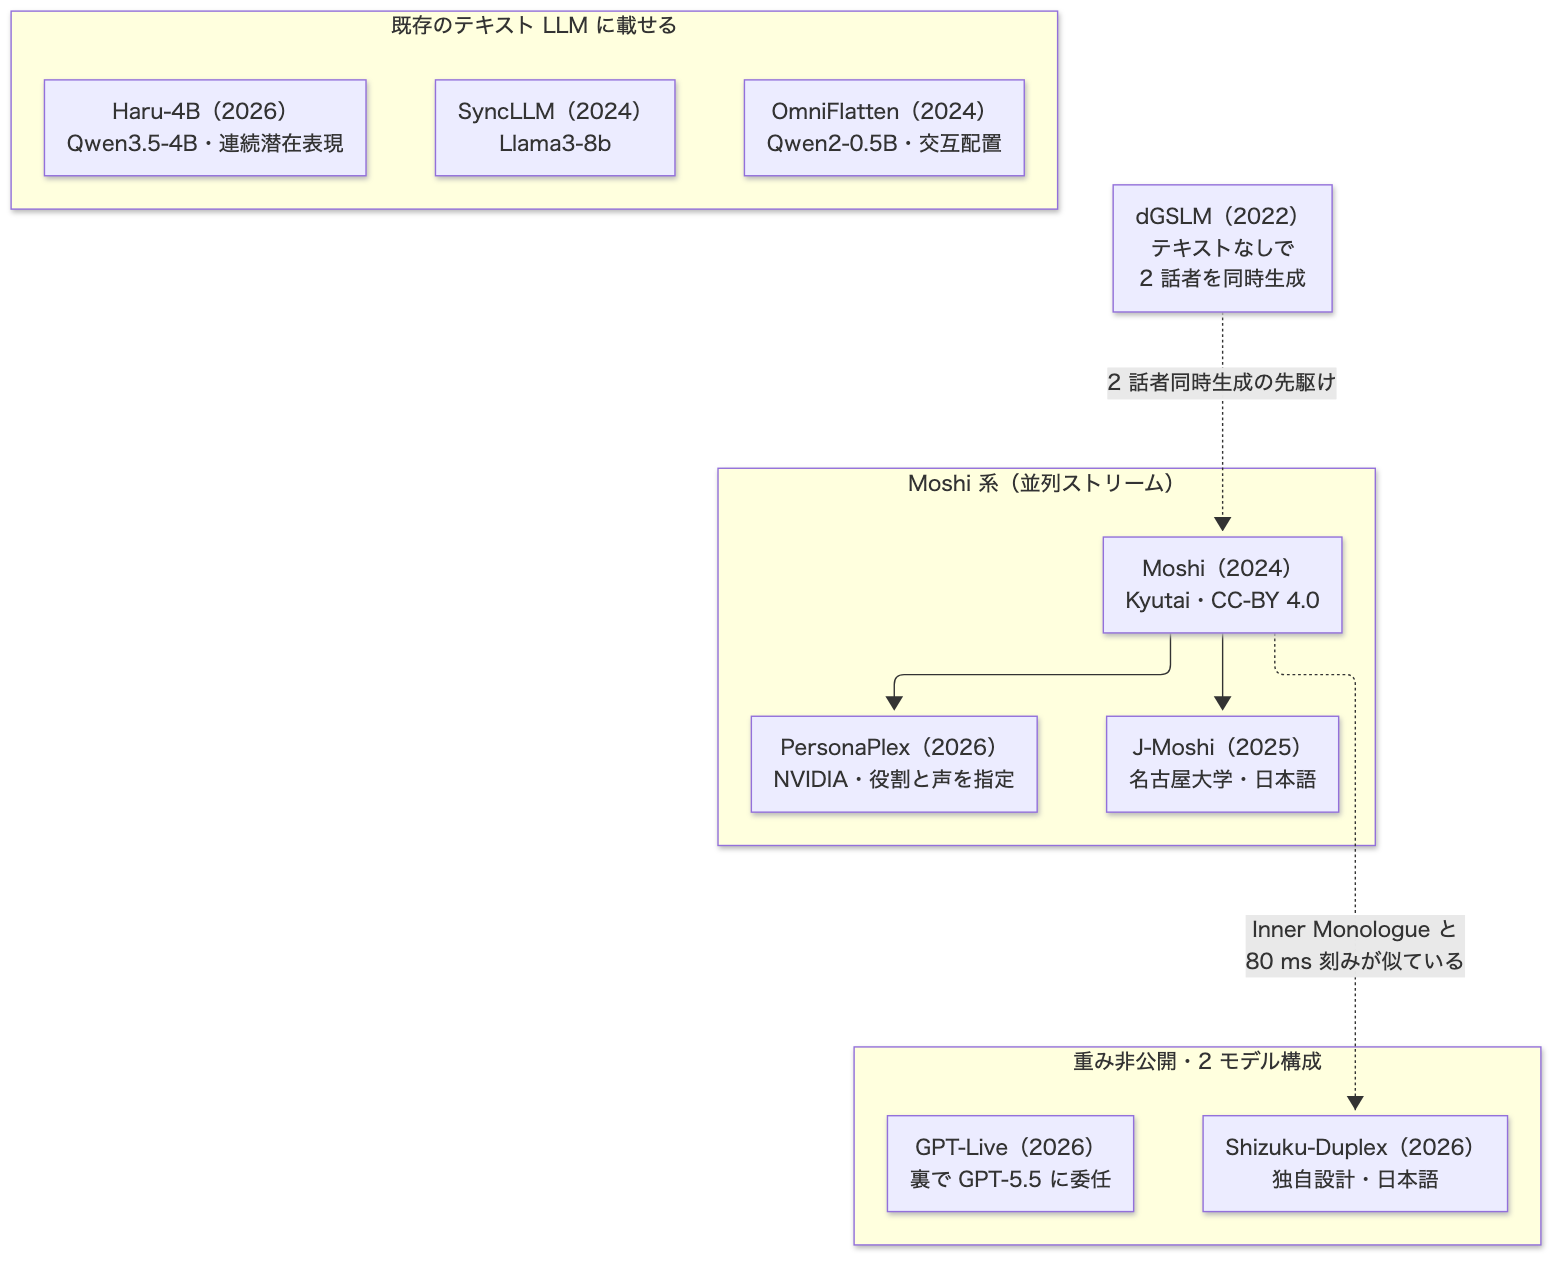
Awesome-Full-Duplex-SDM には、2026 年 11 月時点で 70 を超えるモデルとシステムが並んでいる17。入門で押さえるのは、土台で分けた次の 3 系統で足りる。
| 年 | モデル | 位置づけ |
|---|---|---|
| 2022 | dGSLM | テキストを使わず、Fisher の 2 チャンネル音声約 2,000 時間から 2 話者の会話を同時生成した先駆け3 |
| 2024 | Moshi(Kyutai) | 音声 LLM で全二重を実用的な遅延で実現。重み公開12 |
| 2024 | SyncLLM | Llama3-8b に時間同期を付与4 |
| 2024 | OmniFlatten | チャンク交互配置で GPT 型を流用5 |
| 2024 | Freeze-Omni | テキスト LLM を凍結したまま音声入出力を接続6。Full-Duplex-Bench ではカスケード寄りの扱い13 |
| 2025 | J-Moshi(名古屋大学) | Moshi を日本語化。著者によれば初の公開日本語全二重モデル7 |
| 2026 | PersonaPlex(NVIDIA) | Moshi ベース。テキストで役割、音声プロンプトで声を指定できる910 |
| 2026 | MiniCPM-o 4.5 | 9B。見る、聞く、話すを同時に行う omni 型。12GB 未満の端末で動くとされる12 |
| 2026 | NemotronLabs VoiceChat | 発話と並行して関数呼び出しを別ストリームで出力する公開全二重モデル11 |
| 2026 | GPT-Live(OpenAI) | ChatGPT Voice の全二重モデル。難しい依頼は裏で GPT-5.5 に任せる22 |
| 2026 | Shizuku-Duplex(Shizuku AI) | Moshi に依存しない独自設計の日本語モデル。会話用と裏方用の 2 モデル構成。重みは非公開20 |
| 2026 | Haru-4B(higurashi) | Qwen3.5-4B ベース。離散トークンでなく連続潜在表現で音声を扱う。日本語を含む 9 言語、Apache 2.02324 |
2026 年の流れを見ると、「自然に話せる」段階から「役割を守る」「ツールを呼ぶ」「映像も見る」へと、実務で使う機能に重心が移っている。
評価:速さと判断の適切さを分けて測る
Full-Duplex-Bench(ASRU 2025)は、冒頭の 4 つの振る舞いを自動指標で測る13。中心になる指標は TOR(Takeover Rate、モデルが発話権を取った割合)で、場面によって望ましい向きが逆になる。
| 場面 | TOR の望ましい向き | 他の指標 |
|---|---|---|
| ポーズ処理 | 低いほど良い(黙っても割り込まない) | — |
| 相づち | 低いほど良い | 相づちの頻度、人間とのタイミングのずれ(JSD、低いほど良い) |
| ターン交代 | 高いほど良い(話し終えたら取る) | 応答遅延(低いほど良い) |
| 割り込み対応 | 高いほど良い(割り込まれたら応じる) | GPT-4o による応答品質 0〜5、割り込み後の遅延 |
v1 の結果は、この分野の課題をよく表している13。
- Moshi はターン交代の遅延が 0.265 秒と最速だが、ポーズ処理の TOR は合成データで 0.985 あり、ユーザーが黙るとほぼ必ず話し始める。割り込み後の応答品質も 0.765 と低い
- Gemini Live(gemini-2.0-flash-live-001)はポーズ処理の TOR が 0.255 と最も待てるが、ターン交代の遅延は 1.301 秒
- Freeze-Omni は割り込み後の応答品質が 3.615 と最も高いが、遅延は 1.409 秒
つまり 2025 年時点では、速いモデルは空気が読めず、空気が読めるモデルは遅かった。
v1.5 は、割り込み、相づち、第三者への話しかけ、背景の話し声という 4 種類の重なりを追加した14。評価した 5 つのモデルは、すぐ反応する「応答型」と、重なりを無視して話し続ける「発話権保持型」に分かれた。
その後の改善例として、PersonaPlex の論文は Moshi を同じベンチで比較している10。ポーズ処理の TOR(合成データ)は Moshi の 0.985 に対し 0.584 まで下がった。なお研究ページのグラフ9には単位も数値も異なる値が載っており、比較には論文の表を使いたい。
日本語の状況
日本語は相づちが多く、英語より全二重の難易度が高いとされる。J-Moshi は Moshi を土台に、大規模な日本語音声対話で事前学習し、高品質なステレオ対話データでファインチューニングする 2 段階で作られた7。テキスト対話コーパスからマルチストリーム TTS で合成した音声を足したのが j-moshi-ext である78。
モデルカードの注意書きは、期待値を合わせるうえで重要である8。
- ライセンスは CC BY-NC 4.0(研究用途)
- 推論には 24GB 以上の VRAM を持つ Linux GPU 機が必要で、macOS は非対応
- 学習データの大半が雑談なので、ユーザーの指示には従えないことが多い
- 自分の声がマイクに回り込まないよう、ヘッドホンの使用を推奨
J-Moshi は「日本語で聞きながら話す」振る舞いの研究用プロトタイプであり、質問応答アシスタントとして使えるものではない。
2026 年秋:日本語の全二重モデルが相次いで登場
Shizuku-Duplex:テンポは GPT-Live 並み、中身はあと一歩
Shizuku AI が 2026 年 11 月 8 日に発表した日本語の全二重モデルで、AI キャラクター「しずく」の基盤技術として作られた20。npaka 氏の note が、この発表を全二重モデルの歴史とあわせて解説している21。
公式ブログによると、仕組みは Moshi とよく似ている20。80 ms ごとにユーザーの声を聞いて自分の音声を出し、Inner Monologue のテキストを音声より少し先に書く。ただしアーキテクチャと学習は自社設計で、Moshi ベースではない。ベースの LLM 名とパラメータ数は公表されていない。
特徴は 2 モデル構成にある。
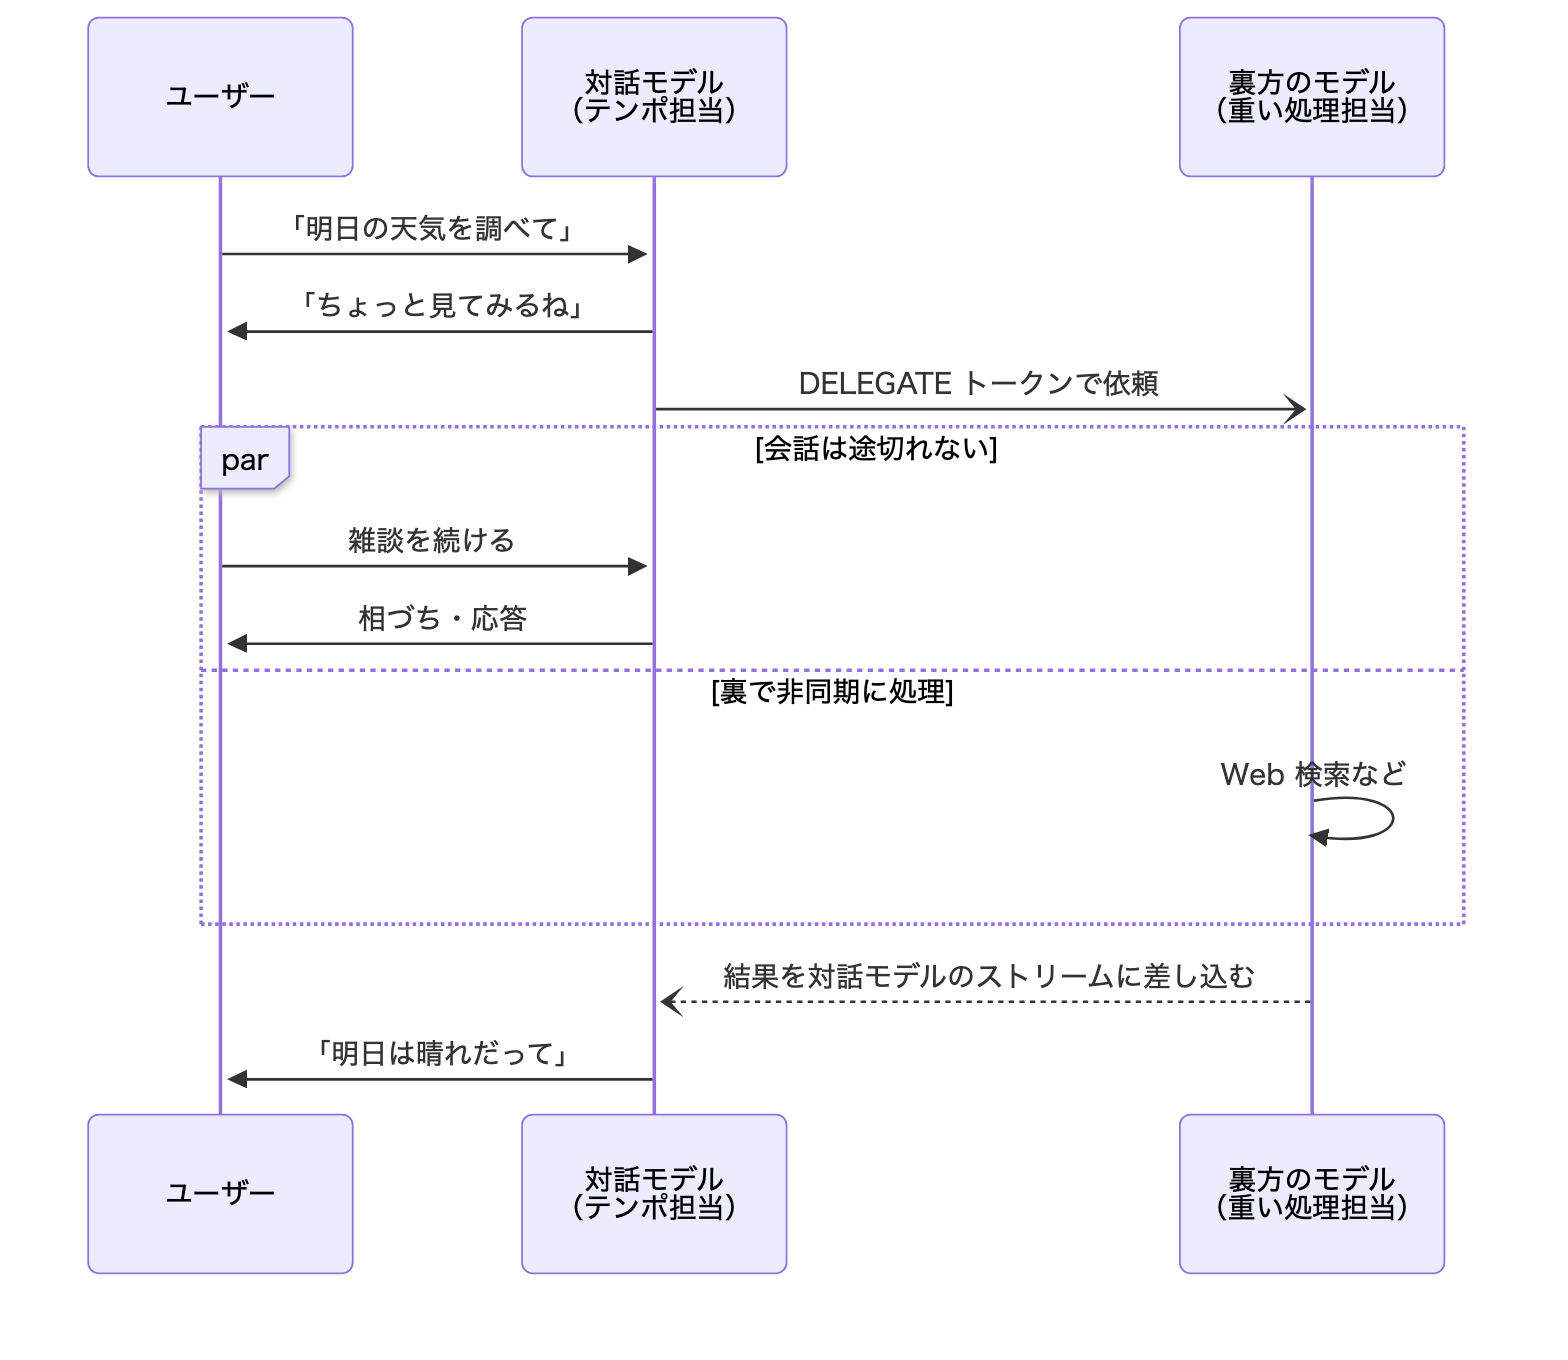
会話を担う対話モデルは、手に負えない依頼が来ると DELEGATE という特殊トークンを出す。すると裏方のモデルが Web 検索などを非同期に実行し、結果を対話モデルのストリームに差し込む。その間も会話は途切れない。約 5 分ごとに会話を要約して文脈を作り直す仕組みや、Live2D の動きを選ぶ出力ヘッドも持つ20。GPT-Live も難しい依頼を裏で GPT-5.5 に任せる構成で22、「テンポを守る対話モデル」と「考える裏方のモデル」を分ける設計が商用側の流れになりつつある。
この形は、Claude Code を使っていると見覚えがある。メインのセッションで話しながら、重い調査はバックグラウンドの subagent に投げ、終わったら結果が会話に戻ってくる。Super-agent の記事 で整理した、軽いモデルで対話と振り分けだけをする Router と、重いタスクを担う Worker の 2 層とも同じ構図である。
| 2 モデル構成の部品 | Claude Code で言うと |
|---|---|
| 対話モデル(テンポ担当) | メインのセッション。ユーザーとのやりとりを止めない |
| DELEGATE トークン | subagent を起動する Agent ツールの呼び出し |
| 裏方のモデル(非同期) | バックグラウンドで動く subagent や run_in_background のコマンド |
| 結果をストリームに差し込む | 完了通知が会話に戻ってくる |
| 約 5 分ごとの要約 | /compact による文脈の圧縮 |
テキストのエージェントで「待たせない」ための構造と、音声でミリ秒単位のテンポを守るための構造は、同じ形をしている。
評価は、Full-Duplex-Bench v1 / v1.5 と M3-DuplexBench を参考に作った独自の日本語ベンチマークで行っている20。主な数値を抜き出す。
| 指標(高いほど良い) | Shizuku-Duplex | GPT-Live-1 | J-Moshi-ext | GPT-Realtime-2.1 | Gemini 3.8 Live |
|---|---|---|---|---|---|
| 間(ポーズ)で発話を奪わない | 98% | 96% | 64% | 98% | 68% |
| 相づちを受けても話し続ける | 95% | 88% | 80% | 0% | 13% |
| 割り込みで 2 秒以内に止まる | 89% | 82% | 73% | 100% | 100% |
| 複数ターン質問応答の正答率 | 79% | 95% | 1% | 96% | 98% |
| 雑談の関連性(1〜10) | 6.5 | 8.5 | 3.2 | 8.4 | 8.4 |
| 第三者への話しかけで発話を奪わない | 17% | 3% | 0% | 5% | 3% |
| 背景の話し声で発話を奪わない | 25% | 8% | 5% | 32% | 17% |
読みどころは三つある。
- 既定設定の GPT-Realtime と Gemini Live は、この評価では相づちでほぼ必ず話を止めた(話し続ける割合 0% と 13%)。ユーザーが「うん」と言うたびに黙るのは、VAD でターンを切る方式の弱点と整合する。VAD の調整で変わる可能性はある
- J-Moshi の質問応答正答率が 1% にとどまる一方、Shizuku-Duplex は 79% まで来た。日本語の全二重モデルが「答えの中身」でも商用 API に近づき始めている
- 第三者への話しかけや背景の話し声を自分宛てと誤認しない割合は低い。最高でも GPT-Realtime の背景の話し声で 32%、多くは 2 割以下である。全二重の未解決課題がここに残っている
ただし割り引いて読む点もある。これは開発元による自己評価で、ベンチマークのデータを公開するという記載はない。関連性や自然さの採点は LLM(Claude Opus 5.5)が行っている。応答時間(中央値 Shizuku 0.57 秒、GPT-Live 0.53 秒、Gemini Live 1.27 秒、GPT-Realtime 1.61 秒)は、前二者がサーバー側、後二者がクライアント側で測っており、条件がそろっていない20。
Haru-4B:日本語も話せる、手元で動く公開モデル
株式会社 higurashi が 2026 年 11 月 13 日に公開した全二重の基盤モデルである23。重みとコードは Apache 2.0 で、商用利用もできる2425。
Moshi との違いは、音声の表し方と学習データにある23。
- 音声表現:Moshi は音声を 8 個の離散トークンにするが、Haru は 7.5 Hz(1 フレーム約 133 ms)の 64 次元の連続ベクトルのまま扱う。音声の生成は、軽い MLP ヘッドが MeanFlow という手法で 1 ステップで行い、Moshi の Depth Transformer に当たる部品が要らない
- ベース LLM:Qwen3.5-4B
- 学習データ:160 以上の言語にまたがる 4,000 万時間超の実音声で事前学習した。2 話者を分離した全二重の対話データも 1,300 万時間超ある。LLM で作った対話や TTS の合成音声は使っていない。Moshi が合成データで 2 話者会話の不足を補ったのとは逆の方針である
遅延は、MacBook(M1 Max、int8 重み)でモデル 1 ステップが 34.2 ms、マイクからヘッドホンまでの合計が p50 で 65.2 ms と報告されている23。この値には、フレーム化による最大 133 ms のアルゴリズム遅延は含まれない。
注意点もある。公開されたのは事前学習済みのベースモデルで、アシスタントのようには指示に従わない2425。2 話者の分離は機械で行っているため、発話が重なる部分に分離の誤りやノイズが残ることがあると、ブログ自身が限界に挙げている23。重なりは全二重の核心なので、ここは今後の改善点になる。ベンチマークによる定量評価はブログに載っておらず、デモ動画での紹介にとどまる。
全二重モデルと「ターン制の omni モデル」は別物
Liquid AI の LFM3-Omni-2B は、2026 年 10 月 27 日に発表された LFM3 ファミリー26の omni モデルである27。テキスト、画像、動画、音声を入力に取り、テキストか音声、または両者を交互に混ぜて出力する。総パラメータは 2.17B で、スマートフォンやノート PC などのエッジ機器向けである。
ただしモデルカードが説明しているのは、ターン制のチャットである27。全二重の動作には触れておらず、少なくとも公開情報からは全二重モデルとは読めない。音声特化の兄弟モデル LFM3-Audio-2B も、話している最中から先読み処理を進めて最初のトークンまでを最短 50 ms に縮める設計で28、これは発話の終わりからの待ち時間を詰める工夫であり、聞きながら話すこととは別物だ。
ターン制 omni モデルでは、「いつ話し始め、いつ止まるか」をモデルの外の VAD やアプリ側が決める。全二重モデルは、それをモデル自身が 80 ms などの刻みで判断する。「omni」と「全二重」は別の軸で、MiniCPM-o 4.5 のように両方を備えるモデルもある12。
| モデル | 対話方式 | 規模 | 日本語 | 重み・ライセンス | Mac |
|---|---|---|---|---|---|
| Moshi | 全二重(並列ストリーム) | 7B 級 | ✕(英語) | 公開、CC-BY 4.02 | ◯ MLX 版2 |
| J-Moshi-ext | 全二重(Moshi ベース) | 7B 級 | ◯ | 公開、CC BY-NC 4.0(研究用途)8 | ✕(Linux GPU 24GB)8 |
| PersonaPlex | 全二重(Moshi ベース) | 7B | 未記載(実会話データは英語) | 公開、NVIDIA Open Model License9 | 未確認 |
| Haru-4B | 全二重(連続潜在表現) | 4B | ◯(9 言語の一つ) | 公開、Apache 2.024 | ◯ MLX と macOS アプリ25 |
| Shizuku-Duplex | 全二重(独自設計+裏方モデル) | 非公表 | ◯(日本語特化) | 非公開20 | — |
| GPT-Live-1 | 全二重(裏で GPT-5.5 に委任) | 非公表 | ◯(Shizuku の日本語ベンチで評価対象20) | 非公開、ChatGPT Voice で提供22 | — |
| MiniCPM-o 4.5 | 全二重 omni(見る・聞く・話す) | 9B | ✕(音声対話は英語と中国語) | 公開、Apache 2.030 | ◯ llama.cpp-omni(全二重は M4 Max・24GB 以上)30 |
| LFM3-Omni-2B | ターン制 omni(全二重の記載なし) | 2.17B | ◯(音声 19 ロケールに含む。音声対話の品質は未確認) | 公開、LFM Open License v1.027 | ◯ llama.cpp 用 GGUF27 |
| LFM3-Audio-2B | ストリーミング(全二重の記載なし) | 2B | △(音声チャットとライブ ASR は英語のみ) | 公開、LFM Open License v1.028 | ◯ 4bit MLX28 |
ライセンスで見落としやすいのは LFM Open License で、年間売上 1,000 万ドル以上の事業者による商用利用は許諾外になる29。Haru-4B の Apache 2.0 とは条件が大きく違う。
触ってみるなら
Mac で日本語の全二重を試すなら、Haru-4B が第一候補である。GitHub に MLX 実装とネイティブ macOS アプリがあり、haru_mlx/swift で ./build_app.sh を実行してビルドする25。NVIDIA GPU なら約 12GB のメモリで動く24。ベースモデルなので、会話の中身より「聞きながら話す」振る舞いを見る目的で触るとよい。
英語で完成度の高い全二重を体験するなら、Moshi の MLX 版も手軽である2。どのモデルも、自分の声がマイクに回り込まないようヘッドホンで試したい。製品として日本語の全二重を体験するなら ChatGPT Voice(GPT-Live)がある22。
考察:ローカルの全二重が効くのは災害現場
ここからは自分の考えである。
調べながらずっと考えていたのは、これがどこで役に立つかだった。全二重が効くのは、声が重なる場面と、テキストを打つ余裕がない場面である。そこに「ネットに載せられるか」という軸を足すと、ローカルで動く全二重の居場所が見えてくる。
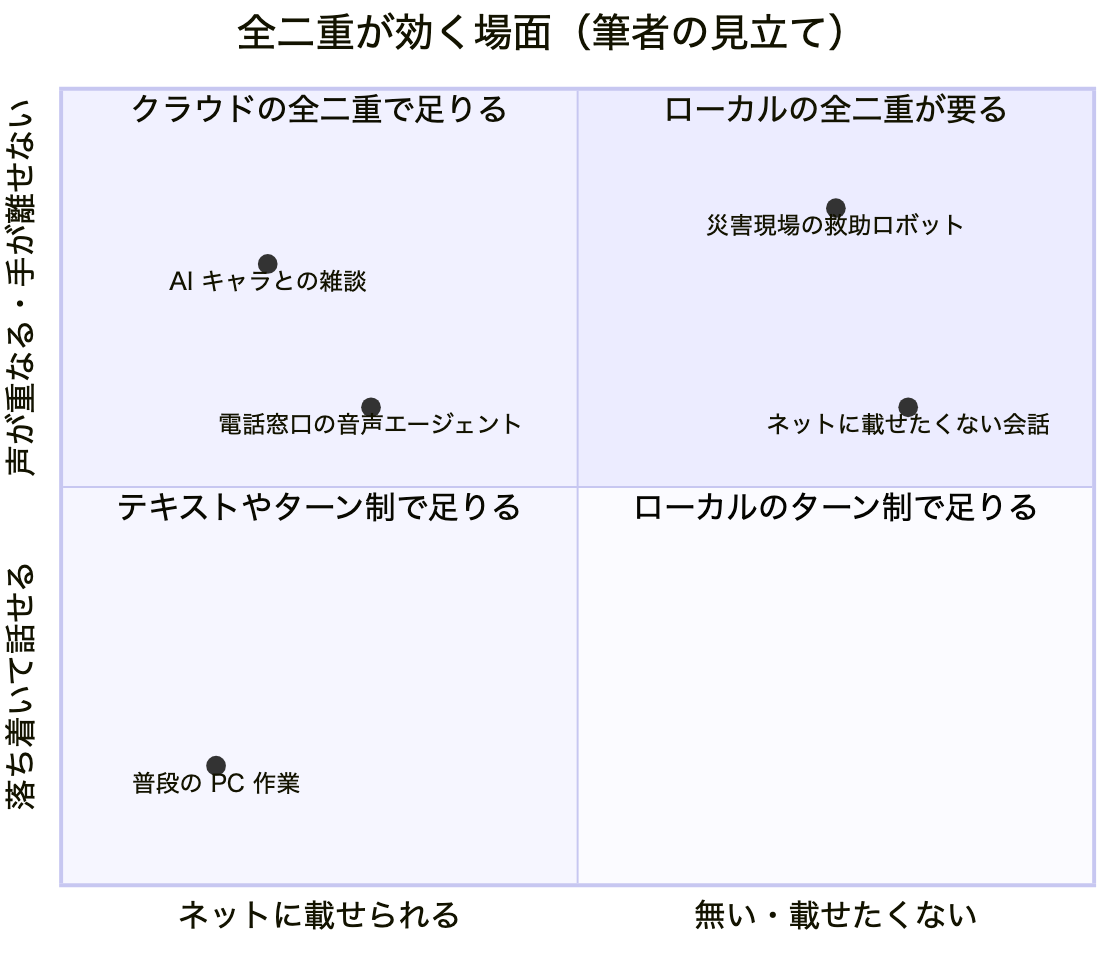
ネットに載せられる場面なら、GPT-Live のようなクラウドの全二重で足りる。Shizuku-Duplex も GPT-Live も重みは公開されておらず、手元では動かせない。ローカルで動く全二重がどうしても要るのは、ネットが無く、しかも声が重なる場面である。
ズバリ、それは災害現場だと思う。インターネットが通じない場所でロボットが救助にあたるとき、救助する側も助けを求める側も急いでいて、声は重なる。「そこじゃない」「待って」と割り込むこともあるだろう。テキスト入力なんてしている場合じゃない。ターン制のアシスタントのように、相手が話し終わるのを待って、無音を確かめてから応答する余裕はない。聞きながら話せて、割り込まれたらすぐ止まれて、ネットが無くても動く。この 3 つが同時に要る場面は、ほかにあまり思いつかない。
ここで一つ疑問が湧いた。スターリンクのような衛星通信があれば、災害時でもクラウドの全二重が使えるのではないか。ただ、被災した全員が衛星通信を使えるようになるとは思えない。衛星経由の回線でどこまで速度が出るのかも、自分にはわからない。全二重は 80 ms 刻みで聞いて話すので、回線の遅れはそのまま会話のテンポに響くはずだ。だから結論は変わらず、ネットに頼らずロボットの中で完結するローカルの全二重が要ると考えている。
では、今の技術はどこまで来ているか。この記事で見てきた公開情報を、災害現場で要りそうなものに当てはめてみた。
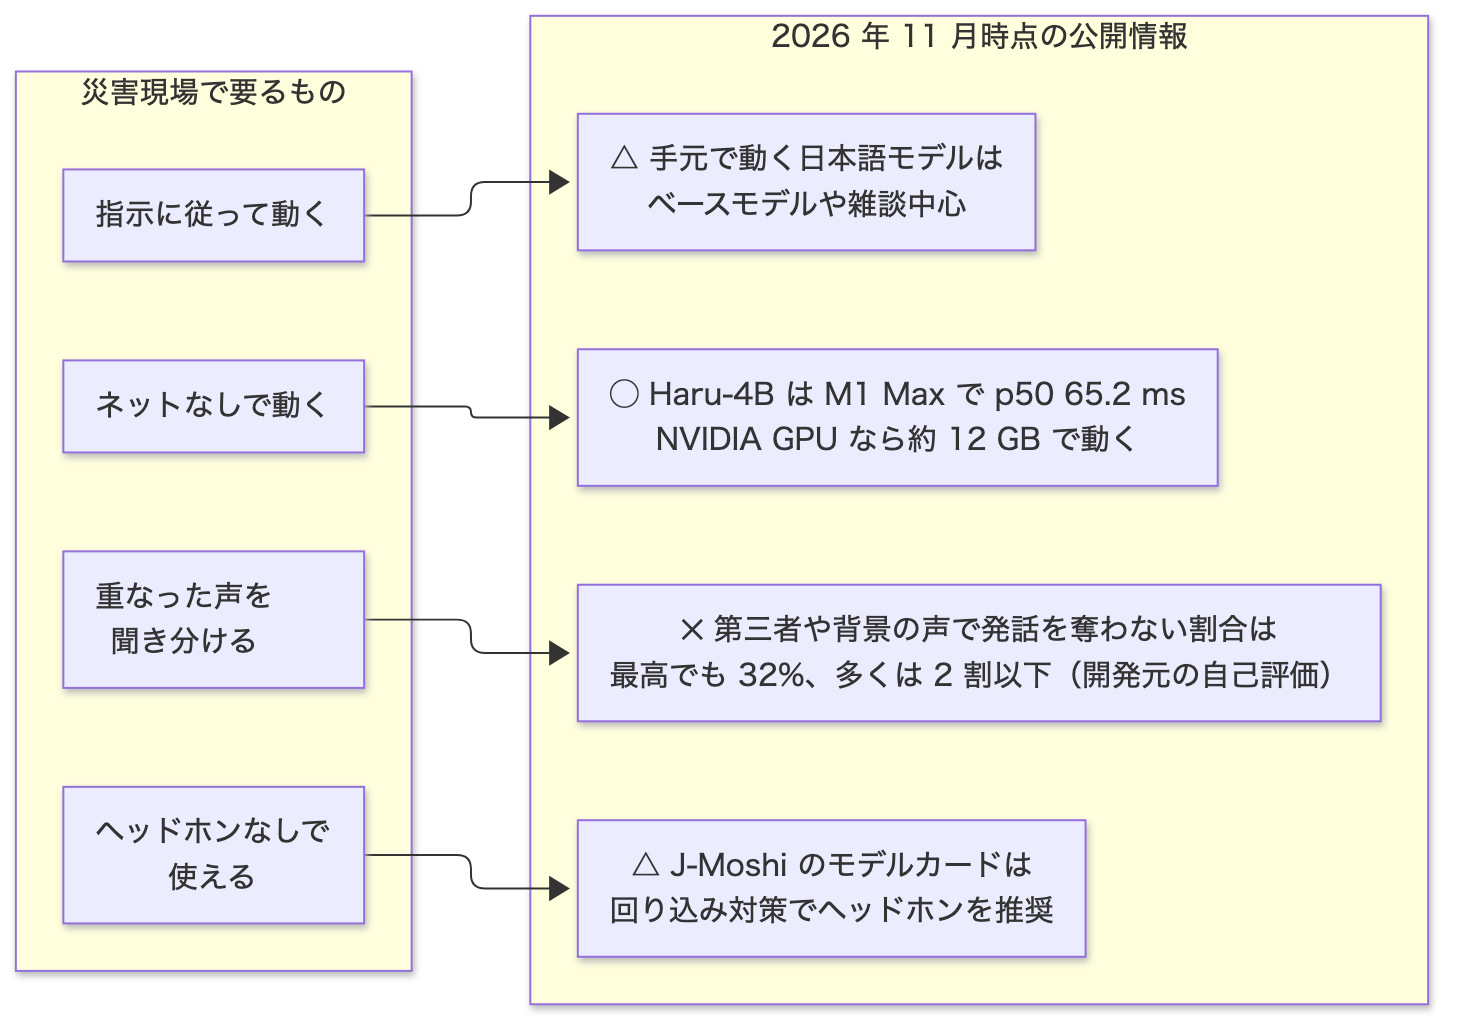
ネットなしで動く点は、もう現実的になっている。Haru-4B は M1 Max のノート PC で動き、NVIDIA GPU なら約 12GB で足りる2324。ロボットに載る計算機で動くかはまだわからないが、4B 級で全二重が回るのは大きい。
足りないのは残りの 3 つで、特に重なった声の聞き分けである。Shizuku AI の評価では、第三者への話しかけや背景の話し声を自分宛てと誤認しない割合は、最高でも 32% で、多くのモデルは 2 割以下だった20。開発元の自己評価ではあるが、用意されたベンチマークの条件でこの数字なら、複数人が叫び合う現場で使うのはまだ難しそうだ。Haru-4B のブログも、発話が重なる部分の話者分離の誤りを限界に挙げている23。手元で動く日本語モデルはベースモデルや雑談中心で、指示に従って動く段階にはない824。J-Moshi のモデルカードにある、自分の声の回り込みを避けるためのヘッドホン推奨8も、スピーカーで周囲に話しかけるロボットとは相性が悪い。
逆に言えば、この分野の未解決課題は、そのまま災害現場で必要な能力の一覧になっている。だから発展は楽しみにしている。
一方で、自分の普段の作業に引きつけると、直近の使い道はあまりない。仕事は PC の前で Claude Code とテキストでやりとりしていて、声が重なる場面も、ネットが切れる場面もほとんどない。さきほどの 4 象限の図でいえば左下にいる。興味のある分野として追いかけつつ、使うのはもう少し先になりそうだ。
もう一つの用途:ネットに載せたくない会話
災害とは別に、ネットが無いのではなく、ネットに載せたくない場面もありそうだ。AI と性的な会話をしたい人はいるだろうし、悪事の相談に使いたい人もいるだろう。クラウドのサービスなら、会話は提供元のサーバーを通り、利用規約やフィルタもかかる。ローカルで動くモデルなら、どちらも通らない。
重みが公開されたモデルは、手元に落とせば提供元はもう使い方を止められない。会話を誰にも渡さずに済むという長所と、悪用を止められないという短所は、同じ性質の裏表である。ローカルの全二重が普及すれば、この用途も必ずついてくると思う。
自分の結論
全二重音声モデルは、2024 年の Moshi で「聞きながら話す」が実用的な遅延で動くようになり、2026 年秋には日本語でも、手元で動く公開モデルとテンポで商用並みのモデルが出てきた。ただし、第三者や背景の声を自分宛てと誤認しない力は、どのモデルもまだ低い。
ローカルの全二重が本当に効くのは、ネットが無く、声が重なり、テキストを打つ余裕もない災害現場だと思う。今の技術はネットなしで動くところまでは来ていて、足りないのは重なった声の聞き分けである。衛星通信が広まっても、全員が使えて速度も足りるとは限らないので、この見立ては変わらない。ネットに載せたくない会話もローカルの用途になりうるが、それは悪用を止められないことと裏表である。発展を期待しつつ、自分の普段の作業では直近の使い道があまりないので、しばらくは興味のある分野として追いかけるつもりだ。
参考文献
- Alexandre Défossez et al. Moshi: a speech-text foundation model for real-time dialogue. arXiv:2410.00037, 2024. https://arxiv.org/abs/2410.00037
- kyutai-labs/moshi(GitHub) https://github.com/kyutai-labs/moshi
- Tu Anh Nguyen et al. Generative Spoken Dialogue Language Modeling(dGSLM). arXiv:2203.16502, 2022. https://arxiv.org/abs/2203.16502
- Bandhav Veluri et al. Beyond Turn-Based Interfaces: Synchronous LLMs as Full-Duplex Dialogue Agents(SyncLLM). EMNLP 2024. https://arxiv.org/abs/2409.15594
- Qinglin Zhang et al. OmniFlatten: An End-to-end GPT Model for Seamless Voice Conversation. arXiv:2410.17799. https://arxiv.org/abs/2410.17799
- Xiong Wang et al. Freeze-Omni: A Smart and Low Latency Speech-to-speech Dialogue Model with Frozen LLM. arXiv:2411.00774. https://arxiv.org/abs/2411.00774
- Atsumoto Ohashi, Shinya Iizuka, Jingjing Jiang, Ryuichiro Higashinaka. Towards a Japanese Full-duplex Spoken Dialogue System. Interspeech 2025. https://arxiv.org/abs/2506.02979
- nu-dialogue/j-moshi-ext モデルカード(Hugging Face) https://huggingface.co/nu-dialogue/j-moshi-ext
- NVIDIA ADLR. PersonaPlex: Natural Conversational AI With Any Role and Voice. https://research.nvidia.com/labs/adlr/personaplex
- PersonaPlex: Voice and Role Control for Full Duplex Conversational Speech Models. arXiv:2602.06053. https://arxiv.org/abs/2602.06053
- Jagadeesh Balam et al. NemotronLabs VoiceChat: An Open Full-duplex Speech-to-Speech Model with Tool Calling Capabilities. arXiv:2609.21967. https://arxiv.org/abs/2609.21967
- Junbo Cui et al. MiniCPM-o 4.5: Towards Real-Time Full-Duplex Omni-Modal Interaction. arXiv:2604.27393. https://arxiv.org/abs/2604.27393
- Guan-Ting Lin et al. Full-Duplex-Bench: A Benchmark to Evaluate Full-duplex Spoken Dialogue Models on Turn-taking Capabilities. ASRU 2025. https://arxiv.org/abs/2503.04721
- Full-Duplex-Bench v1.5: Evaluating Overlap Handling for Full-Duplex Speech Models. arXiv:2507.23159. https://arxiv.org/abs/2507.23159
- Yuxuan Chen, Haoyuan Yu. From Turn-Taking to Synchronous Dialogue: A Survey of Full-Duplex Spoken Language Models. arXiv:2509.14515. https://arxiv.org/abs/2509.14515
- Jingyu Lu et al. A Survey of Full-Duplex Spoken Dialogue Systems: Architectural Hierarchy, Interaction Ontology, and Decision State Machine. arXiv:2606.19453. https://arxiv.org/abs/2606.19453
- Ruiqi-Yan/Awesome-Full-Duplex-SDM(GitHub) https://github.com/Ruiqi-Yan/Awesome-Full-Duplex-SDM
- OpenAI. Voice activity detection (VAD) — Realtime API. https://developers.openai.com/api/docs/guides/realtime-vad
- Google. Live API capabilities. https://aistudio.google.com/docs/live-api/capabilities
- Shizuku AI. Shizuku-Duplex: 自然な間合いで話す日本語 Full-Duplex モデル. 2026-11-08. https://shizuku.ai/blog/1/
- npaka. Shizuku-Duplexの概要 と Full-Duplex音声対話モデルの歴史. note, 2026-11-08. https://note.com/npaka/n/n918cdbd21199
- VentureBeat. OpenAI launches GPT-Live, a full-duplex voice upgrade that lets ChatGPT talk more like a person. 2026-07-08. https://venturebeat.com/technology/openai-launches-gpt-live-a-full-duplex-voice-upgrade-that-lets-chatgpt-talk-more-like-a-person
- 小峠 陸登(higurashi). Haru-4B: 低遅延・多言語の全二重連続音声対話基盤モデル. 2026-11-13. https://blog.higurashi.ai/melte/haru4b-ja/
- higurashi-ai/Haru-4B モデルカード(Hugging Face) https://huggingface.co/higurashi-ai/Haru-4B
- higurashi-ai/Haru(GitHub) https://github.com/higurashi-ai/Haru
- Liquid AI. Introducing LFM3: Every Modality for Specialized Intelligence. 2026-10-27. https://www.liquid.ai/blog/lfm3
- LiquidAI/LFM3-Omni-2B モデルカード(Hugging Face) https://huggingface.co/LiquidAI/LFM3-Omni-2B
- LiquidAI/LFM3-Audio-2B モデルカード(Hugging Face) https://huggingface.co/LiquidAI/LFM3-Audio-2B
- LFM Open License v1.0(LFM3-Omni-2B 同梱) https://huggingface.co/LiquidAI/LFM3-Omni-2B/blob/main/LICENSE
- openbmb/MiniCPM-o-4_5 モデルカード(Hugging Face) https://huggingface.co/openbmb/MiniCPM-o-4_5