この記事についてClaude(Anthropic)との共同編集により作成されました。
要約
- NCCL は
遅延 × 回数 + サイズ ÷ 帯域で所要時間を見積もり、アルゴリズムとプロトコルの組を選ぶ。v2.29.7 のソースで式を確かめられる- この見積もりで Tree の段数が log で減るのはノード数の部分だけで、1 ノードの中では Ring と同じ段数になる
- Ring と Tree の差が大きく開く報告はノードをまたぐ構成に多く、2 ノードの A100 では 64 MB で 2.9 倍の差があった
- 一方で NVLink の推論では、小さな AllReduce が 11.0 µs から 2.37 µs に縮み、トークン間の時間が 8.7% 減った例がある。こちらは
NCCL_ALGOではなく低遅延の専用カーネルの話である- 自分の結論は、アルゴリズムを触る前に、ノードをまたいでいるかと、1 回の通信が遅延と帯域のどちらで決まっているかを確かめること
きっかけ
前回の入門編 で、Kaggle の ARC Prize 2026 に使っていた L4×4 で NCCL の環境変数を 24 設定試した話を書いた。NCCL_ALGO=Tree は既定の Ring より 1.84 倍遅く、既定を大きく超える設定は無かった。
書き終えたあとで、こう思った。推論だからアルゴリズムの選定が効かなかっただけで、本当は学習のほうが効くのではないか。
調べると、この予想は半分だけ当たっていた。詳細編として NCCL の中身を順に見たうえで、後半でこの問いに答える。入門編の内容(AllReduce、SHM と P2P、nvidia-smi topo -m)は前提にする。
NCCL の中の登場人物
Communicator・Channel・Transport
まず、ログや資料に出てくる 3 つの言葉を整理する。
Communicator(通信に参加する全 GPU の集まり)├── Channel 0 ← データを分割して並列に流す通信路│ ├── Ring / Tree の接続関係│ └── Transport(各区間の実際の転送手段)├── Channel 1└── ...Transport は区間ごとに次から決まる。
| Transport | 使う場面 | 中身 |
|---|---|---|
| P2P | 同じノード | NVLink や PCIe で GPU どうしが直接転送する |
| SHM | 同じノード | CPU 側の共有メモリを経由する |
| NET | 別のノード | InfiniBand、RoCE、ソケットなど |
Channel を増やせば帯域を使い切りやすくなるが、公式によると CUDA の計算資源も多く使う1。NVIDIA のブログも、増やすと計算との競合で全体が遅くなる場合があるとしている2。入門編の表で NCCL_MIN_NCHANNELS=8 が 1.16 倍遅くなったのも、少なくとも増やせば速くなるわけではないことを示している。なお、この変数は 2.17 で非推奨になり、今は NCCL_MIN_CTAS が後継である1。
初期化の流れ
GPU のつながり方から通信の選択肢を作るまでは、次の順に進む3。それぞれ NCCL_DEBUG=INFO と NCCL_DEBUG_SUBSYS でログを見られる。
| 段階 | やること | ログ |
|---|---|---|
ncclTopoGetSystem | GPU・CPU・NIC・スイッチのグラフを作る | GRAPH |
ncclTopoComputePaths | 2 点間の経路を NVLink や PCIe などに分類する | GRAPH |
ncclTopoCompute | Ring や Tree の接続を探索する | GRAPH |
ncclTopoPreset / Postset | 探索結果を各 GPU の Channel に落とす | INIT |
selectTransport | 区間ごとに P2P / SHM / NET を決める | INIT |
ncclTopoTuneModel | 組み合わせごとの遅延と帯域の表を作る | TUNING |
最後の表が、次の節以降の主役である。
アルゴリズムとプロトコルは別の軸
アルゴリズムはデータを回す形で、プロトコルは 1 区間でのデータの送り方である。
アルゴリズム
NCCL_ALGO に指定できる値は次のとおりである1。
| アルゴリズム | 形 | 必要なもの |
|---|---|---|
| Ring | 全 GPU を順に回る | なし |
| Tree | ノードの中を集め、ノード間は木で渡す | なし |
| CollnetDirect / CollnetChain | ネットワークスイッチ上で集計する(SHARP) | SHARP 対応のスイッチ |
| NVLS / NVLSTree | NVSwitch 上で集計する(NVLink SHARP) | 第 3 世代以降の NVSwitch(Hopper 世代〜) |
| PAT | AllGather と ReduceScatter 向けの木 | 2.23 の追加時点では 1 ノード 1 GPU4 |
PCIe だけの L4×4 で実際の候補になるのは Ring と Tree だけである。
プロトコル
3 つのプロトコルの違いは、NCCL の内部を分析した論文「Demystifying NCCL」の表が分かりやすい5。
| プロトコル | 同期の方法 | 1 単位の中身 | 帯域の効率 | 1 段の遅延 |
|---|---|---|---|---|
| Simple | メモリフェンス | データの塊 | ピーク近く | 約 6 µs |
| LL | フラグ | データ 4 B + フラグ 4 B | ピークの 25〜50% | 約 1 µs |
| LL128 | フラグ | データ 120 B + フラグ 8 B | ピークの約 95% | 約 2 µs |
遅延の値は、この論文が使った GH200 と NCCL 2.19.1 での目安である。同じ論文の 16 ノードの測定では、64 KiB 未満は LL と LL128 が速く、GB 級では Simple が大きく勝っていた5。
LL128 が両方に強そうに見えるが、未対応の環境で有効にするとデータが壊れることがあるので、自分で指定する変数ではない1。
NCCL はどう選んでいるか
ここからは、手元の実験と同じ NCCL 2.29.7 のソースを読む6。組み合わせごとの所要時間は次の 1 行で見積もられている。
*time = lat * latCount + nBytes / (1000 * bw);遅延に回数を掛け、サイズを帯域で割って足す。全組み合わせのうち、この値が最小のものが基本的に選ばれる27。小さいデータでは左の項が、大きいデータでは右の項が効く。
遅延 lat の計算は、AllReduce の場合に次の形である(読みやすく整理した)。
// Ring: 全 GPU を回る段数ぶんの遅延を足すnsteps = 2 * (nRanks - 1);nInterSteps = 2 * (nNodes - 1); // うちノードをまたぐ段数lat += (nsteps - nInterSteps) * intraLat + nInterSteps * interLat;
// Tree: ノード内は GPU 数に比例し、log が付くのはノード数だけlat += 2 * ((nRanks / nNodes - 1) * intraLat + log2i(nNodes) * interLat);Tree の log はノード数にしか掛かっていない。「Tree は log(N) で効く」とよく説明されるが、少なくともこの見積もりでは、1 ノードの中の段数は Ring と同じである。最新のソースでもファイルは移ったが、同じ形の式が残っている8。
図にすると次のようになる。
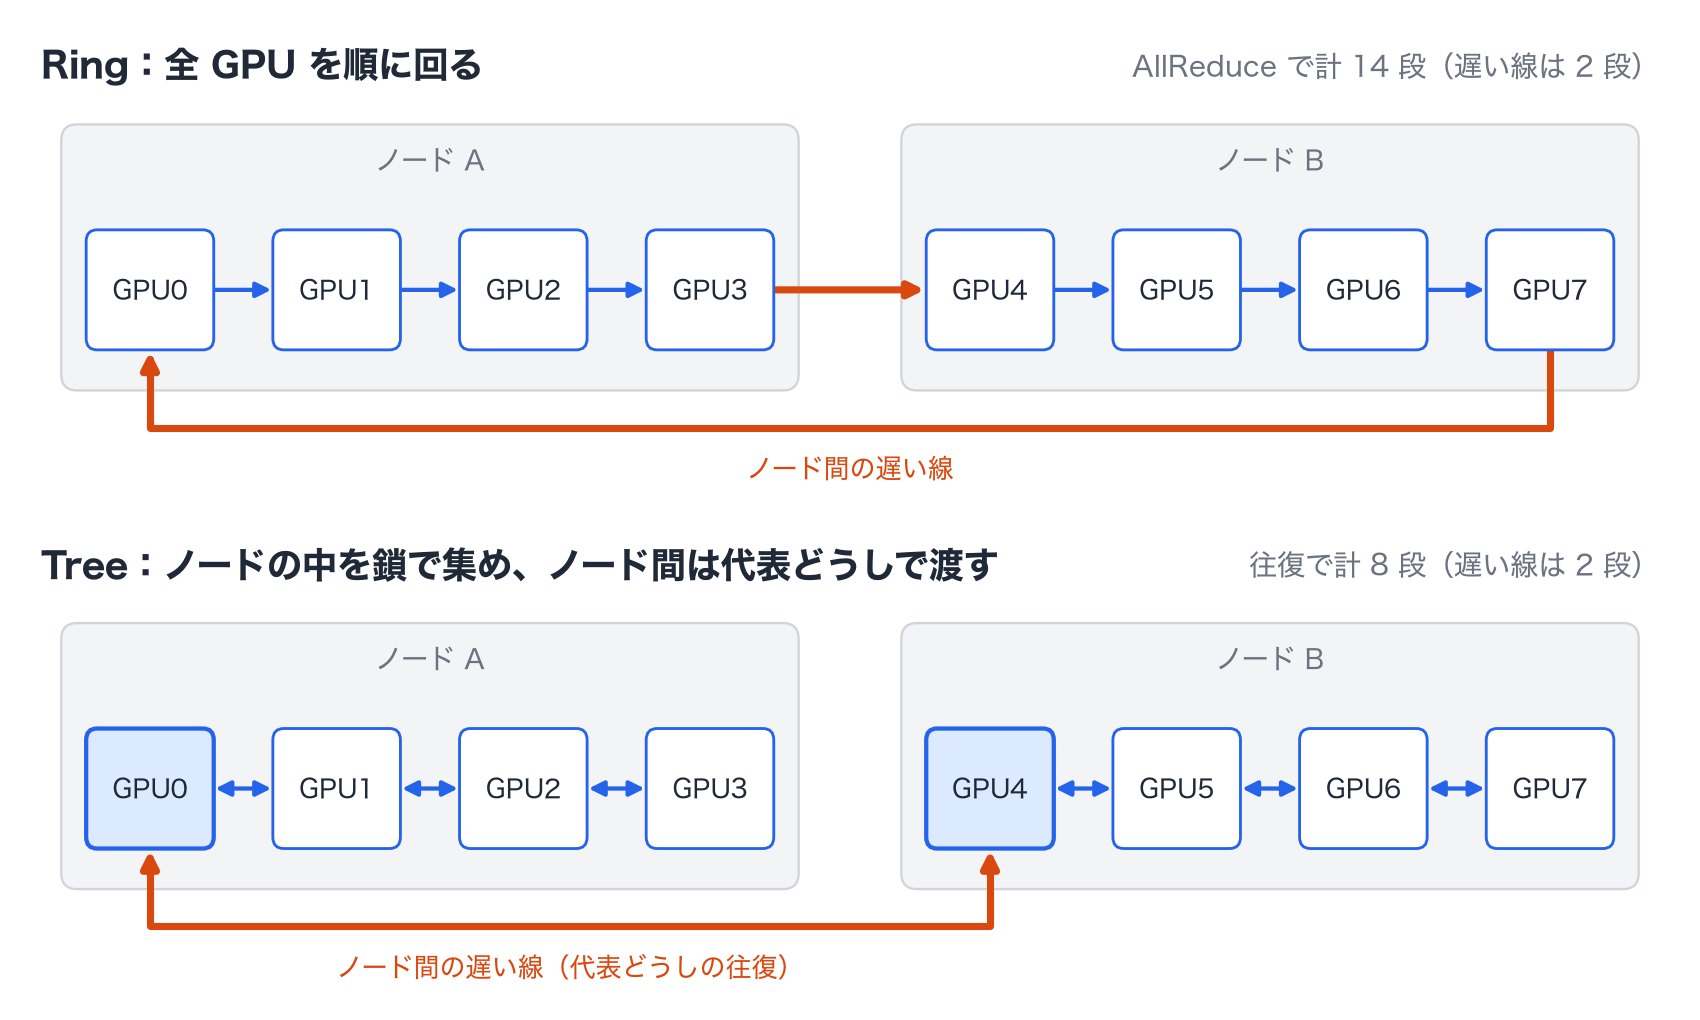
式からノード数を変えて段数を計算すると、差が開くのはノードをまたいだときだと分かる。
| 構成(ノード × GPU) | Ring の段数(うちノード間) | Tree の段数(うちノード間) |
|---|---|---|
| 1 × 4(手元の L4×4) | 6(0) | 6(0) |
| 1 × 8 | 14(0) | 14(0) |
| 2 × 4 | 14(2) | 8(2) |
| 16 × 8 | 254(30) | 22(8) |
| 128 × 8 | 2,046(254) | 28(14) |
ノード間の 1 段は、見積もりの表でも Ring の Simple で 14 µs と、PCIe の 5.7 µs や NVLink の 3.4 µs より重い6。遅い線を渡る回数が 254 回と 14 回では、話が変わってくる。
L4×4 のログが読めるようになった
入門編に載せたログは、4 バイトでも 8 KB でも Algo RING だった。小さいデータなら Tree になりそうなものだが、この式で読むと納得がいく。
NCCL INFO AllReduce: 4 Bytes -> Algo RING proto LL channel{Lo..Hi}={0..0}NCCL INFO AllReduce: 8192 Bytes -> Algo RING proto LL channel{Lo..Hi}={0..0}NCCL INFO AllReduce: 215040 Bytes -> Algo RING proto SIMPLE channel{Lo..Hi}={0..1}PCIe・1 ノード 4 枚・LL での遅延は、ソースの定数から計算すると Ring が 12.6(6.6 + 6 × 1.0)、Tree が 12.8(6.8 + 6 × 1.0)である6。ほぼ同じなので、少なくとも遅延の項には Tree を選ぶ理由が出てこない。
ただ、見積もりと実機が常に合うわけではない。先ほどの Demystifying NCCL は、GH200 の測定でノード内でも小さいサイズでは Tree が良いと報告している5。
NCCL_ALGO=Tree でエラーになった理由
前回の実験では、NCCL_ALGO=Tree にすると AllGather が invalid usage で落ちた。公式の説明を読むと、2.24 からは指定に Ring が含まれない場合、ほかに有効なアルゴリズムが無い集団通信は Ring に戻らず失敗する1。2.29.7 での自分のエラーも、これに当てはまるとみている。
同じ 2.24 から、集団通信ごとに指定できるようになっている1。試すなら次の形が安全である。
NCCL_ALGO="allreduce:tree" # AllReduce だけ Tree を許可するNCCL_ALGO="allreduce:^tree" # AllReduce で Tree だけ外す効くのは学習か推論か
本題に戻る。まず、通信の形が違う。
- 学習(DDP): 勾配をまとめて送る。PyTorch の DDP はバケットの上限が既定で 25 MiB なので9、1 回が大きく、回数は少ない。規模を増やすとノードをまたぐ
- 推論(TP): 層ごとに小さめの AllReduce が走る。L4×4 では 1 歩に 135 回、1 回 600 KB 前後だった。あとで紹介する低遅延の論文によると、TP の組は 1 つの NVLink ドメインに収めることが多い10
調べて見つかった数字を並べる。同じ条件で学習と推論を比べた資料は見つからなかったので、環境がばらばらな点には注意してほしい。
| 場面 | 環境 | 比べたもの | 1 回の通信の差 | 全体への効き |
|---|---|---|---|---|
| ノードをまたぐ | A100 2 × 4、ノード間は TCP11 | Ring と Tree(64 MB) | 337 ms → 117 ms | 通信のみの測定 |
| 上と同じ 8 枚を 1 ノードで | A100 1 × 8、NVLink11 | 自動選択と最良の組(64 MB) | 2.3% の差 | 通信のみの測定 |
| 学習の本番環境 | Meta の RoCE クラスタ12 | ネットワークと NCCL の調整全体 | 2 倍超の例が多い | アルゴリズム単独の値ではない |
| NVLink の推論 | GB200 × 410 | NCCL の Ring と低遅延カーネル | 11.0 µs → 2.37 µs | トークン間の時間 −8.7% |
| PCIe の推論 | L4 × 4(手元) | Ring と Tree | 1.84 倍遅い | 不採用 |
| PCIe の推論 | L4 × 4(手元) | NCCL と custom AllReduce | 4.40 倍遅い | 不採用 |
| PCIe の推論 | L4 × 2(手元) | NCCL と custom AllReduce | 9.07 ms → 6.20 ms(1 歩) | 別の理由で不採用 |
ノードをまたぐと Ring と Tree の差が開く
最初の 2 行は、スタンフォードの授業プロジェクトの測定である11。同じ A100 8 枚でも、1 ノードなら自動選択と最良の組の差は平均 1.2%、64 MB でも 2.3% だった。2 ノードに分けてノード間を約 10 Gbps の TCP にすると、自動選択は全サイズで Ring を選び、最良の Tree との差は 64 MB で 57.2% に広がった。授業の 6 ページの報告で、クラウド上の小さな構成である点は割り引く必要があるが、ノードをまたぐと差が開く点は先の式と合っている。
本番規模では Meta の論文が参考になる12。NCCL の調整は低い遅延(10 µs 未満)の環境を前提にしていて、RTT が 22 µs ある自社の環境では最適にならなかったという。Meta は、NCCL の既定より大きなサイズまで Tree や LL128 を使うように調整した。Ring の AllGather は大きなジョブで遅延が積み上がるとも書いている。
したがって、Ring と Tree の選定が効くのは主にノードをまたぐ場面で、それは多くの場合に学習である。予想が当たっていたのはこの部分である。
NVLink の推論では別の形で効く
外れていたのは「推論では効かない」という部分である。2026 年 7 月の NVIDIA と ETH チューリッヒの論文は、長い文脈の推論を、帯域より遅延が律速になる代表例として扱っている10。バッチが小さくなって 1 回の AllReduce が小さくなり、それがトークン生成の経路に何度も並ぶからである。
GB200 4 枚では、小さなサイズの AllReduce が NCCL の Ring の 11.0 µs から低遅延カーネルの 2.37 µs に縮み、Llama 3.1 70B のトークン間の時間が 8.7% 減った。条件ごとの最良の設定では、4 枚で 7〜13%、8 枚で 9〜11% 減っている10。1 回が 4.6 倍速くなっても全体は 1 割前後である一方、1 割はサービスの費用としては大きい。
このカーネルは、NCCL_ALGO で Ring と Tree を切り替える話とは別物である。
- NCCL は対称メモリ(全 GPU で同じ仮想アドレスを持つバッファ)に登録すると使える低遅延カーネルを 2.27 から用意している13
- vLLM も独自の custom AllReduce を持ち、NCCL の対称メモリを使う
VLLM_USE_NCCL_SYMM_MEM=1も入っている14
つまり、推論ではアプリと NCCL の境界を変える形で選定が進んでいる。vLLM の PR の表には、8 GPU・8 MB で通常の呼び出しが 0.074、対称メモリが 0.037(単位の記載なし)という行がある。ただし、同じ PR のスループットの比較は +3.5% で、比較元の条件が明記されていないので参考程度である14。
PCIe の推論では、そもそも帯域で決まっていた
手元の L4×4 に低遅延の話が当てはまらなかったのは、1 回の通信の大半が帯域で決まっていたからである。データを約 215 KB と約 645 KB にした 2 点で直線を引くと、1 回は固定で約 58 µs、残りはサイズに比例していて、645 KB の 1 回(約 0.25 ms)の 77% が比例の部分だった。2 点だけの概算だが、遅延を削っても縮む余地は小さく、帯域の良い Ring・Simple が選ばれたのは自然である。
vLLM の custom AllReduce の結果も分かりやすかった。
| 構成 | NCCL | custom AllReduce | 測定 |
|---|---|---|---|
| TP2(L4 2 枚) | 9.07 ms | 6.20 ms | 16 本同時・1 歩 128 回 |
| TP4(L4 4 枚) | 33.3 ms | 146.5 ms | 63 行・1 歩 135 回 |
2 枚なら速いのに、4 枚に強制すると 4.40 倍遅い。vLLM は PCIe だけの 3 枚以上で custom AllReduce を切っていて、自分はそれを上書きして試した。P2P が TP4 で遅かった入門編の結果と同じ種類の崩れに見えるが、原因は特定できていない。NCCL 側も 2.29 系のリリースノートに「PCIe では性能が出ないので、組み込みの対称カーネルは NVLink が全結合の環境だけで有効にした」と書いている15。
NVLink 向けの低遅延の工夫は、PCIe の複数枚にはそのまま持ち込めない。これが自分の環境での答えだった。
学習なら L4×4 でも効くのか
ここは未測定である。DDP の 25 MiB は手元の 600 KB よりずっと大きく、1 ノードなら段数の差も無いので、帯域に強い Ring・Simple がそのまま選ばれ、やはり差は小さいと予想している。ただ、自分の実験は推論だけで、これは式からの推測にすぎない。
なお、1 ノードでも既定が常に最良とは限らない。B300 8 枚の測定では、4〜128 MiB の AllReduce で既定の NVLS より Ring のほうが最大で約 27% 速かった16。NVSwitch があると候補が増えるので、PCIe より選定の余地が大きいのかもしれない。
自分の環境で確かめる
アルゴリズムを触る前に、次の順で確かめるとよいと思う。入門編の「速くしたいときの順番」の続きにあたる。
1. 何が選ばれているかを見る
NCCL_DEBUG=INFO NCCL_DEBUG_SUBSYS=TUNING torchrun --nproc_per_node=4 train.py通信のたびに行が出るので、ログを出したまま速さを測らないようにしたい。
2. サイズごとの所要時間を測る
公式の nccl-tests を使えば、サイズを振った測定を簡単にできる17。自分の実験は自作のベンチで、このコマンドは手元の L4×4 では回していない。
# 1 ノード 4 枚で、8 B から 128 MiB まで 2 倍ずつ./build/all_reduce_perf -b 8 -e 128M -f 2 -g 4実際の通信サイズの近くで 2 点を取り、直線を引く。傾きの部分が大きければ帯域で決まっていて、切片の部分が大きければ遅延で決まっている。前者なら量を減らす手、後者なら回数を減らす手や低遅延カーネルが候補になる。
3. ノードをまたぐなら Tree も試す
複数ノードで通信が重いときは、Tree を試す価値がある。1 つの集団通信だけに絞れば、ほかを壊さない。MPI を有効にしてビルドした nccl-tests なら、次のように 2 ノードで比べられる17。
# 2 ノード 8 プロセスで、AllReduce だけ Tree を許可する(OpenMPI の例)mpirun -np 8 -N 4 -x NCCL_ALGO="allreduce:tree" ./build/all_reduce_perf -b 8 -e 128M -f 2 -g 1差が再現して、組織で長く運用するなら、環境変数で固定するより tuner プラグインが筋が良い。NCCL_TUNER_PLUGIN で読み込むプラグインは、サイズや規模ごとの選択を上書きできる12。環境変数はプロセス全体に効くうえ、NCCL を更新したあとも残り続けるからである2。
主な環境変数
公式はデバッグの区分の変数について「実験や問題の切り分けには使ってよいが、本番のコードには基本的に設定しない」としている1。
| 変数 | 内容 | 公式の区分 |
|---|---|---|
NCCL_SOCKET_IFNAME | 初期化の接続に使うネットワーク | システム設定 |
NCCL_IB_HCA | 使う InfiniBand のデバイス | システム設定 |
NCCL_IGNORE_CPU_AFFINITY | 1 で、引き継いだ CPU の割り当てを無視して GPU 側に合わせる | システム設定 |
NCCL_TOPO_FILE | 自動検出の前に読むトポロジの XML | システム設定 |
NCCL_TUNER_PLUGIN | tuner プラグインの指定 | システム設定 |
NCCL_DEBUG / NCCL_DEBUG_SUBSYS | ログのレベルと対象 | システム設定 |
NCCL_BUFFSIZE | 通信バッファ(既定 4 MiB) | デバッグ |
NCCL_ALGO / NCCL_PROTO | アルゴリズムとプロトコルの指定 | デバッグ |
名前に DEBUG が付くものがシステム設定で、NCCL_BUFFSIZE がデバッグ側なのは少し意外だった。
自分の結論
「推論より学習でアルゴリズムの選定が効くのでは」という予想は、Ring と Tree の話としては当たっていた。差を開くのはノードをまたぐことで、それは多くの場合に学習だからである。ただ、推論で効かないわけではなく、NVLink の推論は低遅延カーネルという別の形で 1 割前後の改善を取りにいっている。
だから、アルゴリズムを触る前に、ノードをまたいでいるかと、1 回の通信が遅延と帯域のどちらで決まっているかを確かめること。学習か推論かという分け方より、この 2 つのほうが次の手を決めやすいと思う。手元の PCIe の L4×4 は 1 ノードで帯域律速だったので、24 設定を試しても既定を大きく超えなかったことにも今は納得がいく。
参考文献
- Environment Variables — NCCL documentation https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/env.html
- Understanding NCCL Tuning to Accelerate GPU-to-GPU Communication — NVIDIA Technical Blog https://developer.nvidia.com/blog/understanding-nccl-tuning-to-accelerate-gpu-to-gpu-communication/
- Topology and Tuning: How NCCL Turns Hardware Into Decisions(NCCL リポジトリ内のコミュニティ寄稿、2.30.6 準拠) https://github.com/NVIDIA/nccl/blob/master/docs/contrib/architecture/learning/en/topology-and-tuning.md
- NCCL Release 2.23.4 https://docs.nvidia.com/deeplearning/nccl/release-notes/rel_2-23-4.html
- Demystifying NCCL: An In-depth Analysis of GPU Communication Protocols and Algorithms https://arxiv.org/html/2507.04786v1
- NCCL v2.29.7 src/graph/tuning.cc https://github.com/NVIDIA/nccl/blob/v2.29.7-1/src/graph/tuning.cc
- How does NCCL decide which algorithm to use? · NVIDIA/nccl Issue #457 https://github.com/NVIDIA/nccl/issues/457
- NCCL src/tuning/tree.cc(最新版) https://github.com/NVIDIA/nccl/blob/master/src/tuning/tree.cc
- PyTorch torch/nn/parallel/distributed.py https://github.com/pytorch/pytorch/blob/main/torch/nn/parallel/distributed.py
- Every µs Matters: Achieving Near Speed-of-Light Latency in GPU Collectives https://arxiv.org/abs/2607.16100
- Bandit-Guided NCCL Tuning for Multi-Node GPU Clusters(Stanford CS244C の授業プロジェクト) https://www.scs.stanford.edu/26wi-cs244c/proj/bandit_guided.pdf
- RDMA over Ethernet for Distributed AI Training at Meta Scale(SIGCOMM 2024) https://engineering.fb.com/wp-content/uploads/2024/08/sigcomm24-final246.pdf
- Enabling Fast Inference and Resilient Training with NCCL 2.27 — NVIDIA Technical Blog https://developer.nvidia.com/blog/enabling-fast-inference-and-resilient-training-with-nccl-2-27/
- add nccl symmetric memory for all reduce · vllm-project/vllm PR #24532 https://github.com/vllm-project/vllm/pull/24532
- NCCL Release 2.29.2 https://docs.nvidia.com/deeplearning/nccl/release-notes/rel_2-29-2.html
- NCCLbpf(arXiv:2603.11438) https://arxiv.org/html/2603.11438v1
- NVIDIA/nccl-tests https://github.com/NVIDIA/nccl-tests