


この記事についてClaude(Anthropic)との共同編集により作成されました。
要約
- AIエージェントに構築作業を任せると、シェルやPythonのスクリプトが増え続け、人間がレビューできない状態になりやすい。構築・運用で避けるべきなのはこれだと思っている
- 同じ構築を別の環境でも再現したくなったとき、以前とっつきづらくて放置していた Ansible を試した。レビューと可視化の道具がそろっていたのがよかった
- Ansible は出力の形が「モジュール+パラメータ」に決まり、
--check --diffで実行前に差分を見られ、冪等なのでやり直しが安全。AIが書き、人間が差分を承認するという分担に乗せやすい- さらに、記法をフレームワークが担保するので、流儀の違うシェルを大量に読まずに済む。コミュニティが発達していて、知見を共有・検索しやすいのも利点になる
- ただし
shell/commandに逃げられると利点が消える。ansible-lint(profile: production)と Molecule の idempotence テストで機械的に止めるのが前提になる- GPUサーバーのサンプル構築では、ホスト(ドライバ・Docker・Container Toolkit)を Ansible、アプリを Docker に分け、ドライバとCUDAのバージョンの鎖を group_vars で1か所にまとめる
- レビューを支えるのは可視化。grapher(構造)、
ansible-inventory --graph(変数)、--list-*(実行範囲)、--check --diff(変更内容)をCIで出してMRに貼る
同じシステムの構築を、別の環境でもそのまま再現したくなった。
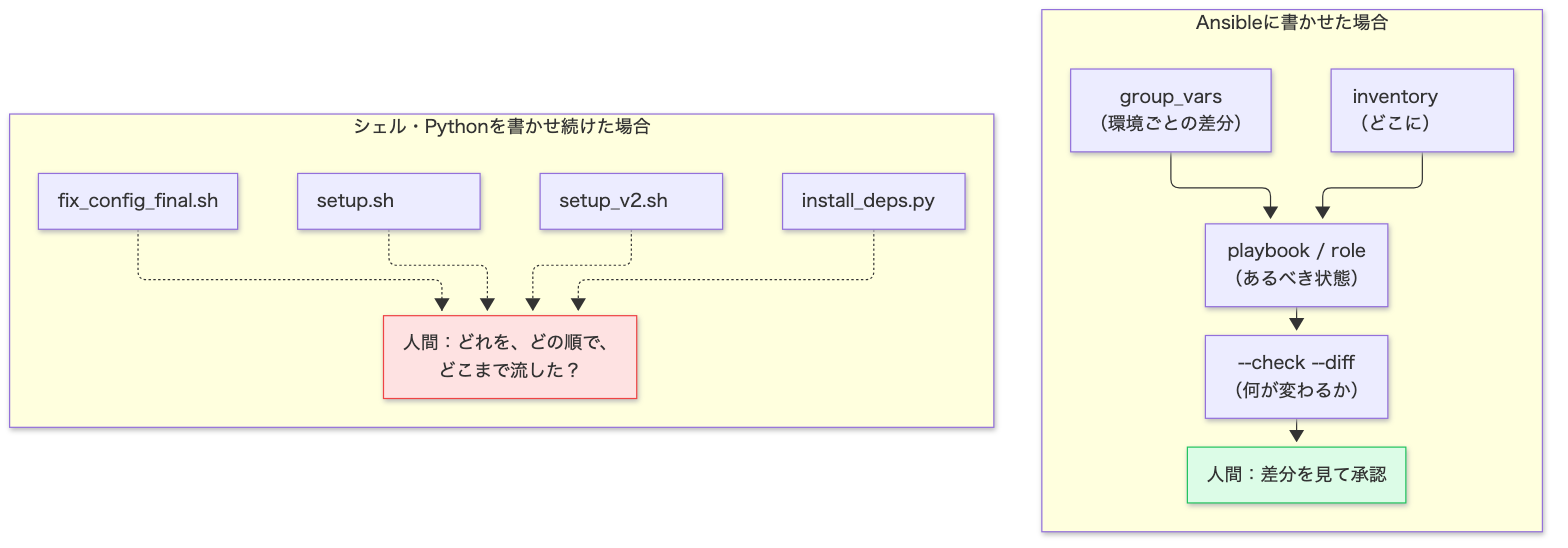
いまなら Claude Code に頼めば、構築用のシェルスクリプトや Python スクリプトはすぐ出てくる。ただ、これを続けると setup.sh、setup_v2.sh、fix_config_final.sh のようなファイルが積み上がっていく。どれを、どの順で、どこまで流したのか。次の環境で同じ結果になるのか。AIが書いたスクリプトが散らかり、人間がレビューできない状態になることが、構築・運用で避けるべきことだと思っている。
そこで思い出したのが Ansible だった。以前はとっつきづらくて放置していたが、改めて試してみると、実行前の差分確認や依存関係の可視化など、レビューのための道具が充実していた。AIエージェントに書かせる前提で見直すと、評価がかなり変わった。
実際の構築例は伏せるが、ローカルの複数の開発環境に同じ変更を入れたいときに使った。この記事では、そのときに調べた内容を整理する。後半の GPU サーバー構築は、調べた内容を具体化するためのサンプル構築例である。
1. AIエージェントと Ansible の相性がよい理由
シェルスクリプトを書かせる場合と比べると、違いは次のとおり。
| 観点 | シェルスクリプトを書かせる場合 | Ansible を書かせる場合 |
|---|---|---|
| 出力のぶれ | 書き方が毎回変わる | 「モジュール+パラメータ」の DSL に制約され、ぶれが小さい |
| 実行前の確認 | 読んで推測するしかない | --check --diff で変更内容をプレビューできる1 |
| 失敗時のやり直し | どこまで実行されたかを人間が追う | 冪等なモジュールなら再実行で収束する |
| 状態の記録 | スクリプトは「手順」で、あるべき状態は読み取れない | inventory・group_vars・role が「あるべき状態」の記録になる |
| 機械的な検査 | shellcheck 程度 | ansible-lint23、Molecule45 が使える |
| 記法の統一 | 書き手ごとに流儀が違い、全部読んで確かめる必要がある | 記法をフレームワークが決めるので、確認するのは主に「どのモジュールに何を渡したか」 |
| 知見の共有・検索 | 書き方が人それぞれで、検索しても自分のケースに当てはまりにくい | モジュール名が共通の語彙になり、公式ドキュメント・Galaxy・フォーラムで探しやすい |
AIにとっての利点は「書きやすさ」より、検査・承認・やり直しの仕組みに乗せやすいことにある。
1.1 check mode と diff mode
ansible-playbook site.yml --check --diff を使うと、リモートを変更せずに「何がどう変わるか」を確認できる1。エージェントが作った playbook の差分を MR に貼り、人間が承認してから適用する、というフローにそのまま組み込める。
注意点もある1。
- check mode は「シミュレーション」で、check mode 非対応のモジュールは何も報告せず、何もしない
- 前のタスクの
register結果に依存する条件分岐は、check mode 中は意味のある結果にならない - diff 出力にはシークレットが含まれうる。該当タスクには
diff: falseを付ける
1.2 冪等性はモジュール単位で成り立つ
Ansible が冪等なのは、各モジュールが「現在の状態」と「あるべき状態」を比べて、差があるときだけ変更するように作られているからだ。shell / command はこの比較をしないので、そのまま書くと毎回 changed になり、冪等性が崩れる。
つまり、Ansible を使っていても中身が shell: だらけなら、散らかったシェルスクリプトと変わらない。次の章のガードレールが必要になる理由はここにある。
1.3 記法がフレームワークで担保される
シェルスクリプトは、同じ処理でも書き方がいくらでもある。パッケージを入れる処理ひとつでも、apt-get install -y か apt install か、dpkg -s で事前に確認するか、set -e を付けるか、エラーをどう扱うかで流儀が分かれる。エージェントに大量に書かせると、流儀の違うシェルが溜まり、その一つひとつを人間が読んで確かめることになる。
Ansible では、この「どう書くか」をフレームワークとモジュールが決める。
- name: Install packages ansible.builtin.apt: name: [curl, gnupg2] state: presentレビューで確認するのは、主に「どのモジュールに、どの値を渡したか」になる。インストール済みかどうかの確認、エラー処理、冪等性はモジュールの側で担保される。記法から外れたものは ansible-lint(2.1節)が機械的に検出する。when の条件やテンプレートは引き続き読む必要があるが、人間が読む量はかなり減る。エージェントが大量に書く時代には、ここが効いてくる。
1.4 コミュニティが発達していて、知見を共有・検索しやすい
- モジュール名が共通の語彙になる: 「
community.docker.docker_compose_v2でstate: restartedにすると冪等でない」のように、問題をモジュール名とパラメータ名で正確に言い表せる。シェルは書き方が人それぞれなので、検索しても自分のケースに当てはまる情報に行き着きにくい - 情報源が整っている: 公式ドキュメントには、モジュールごとにパラメータ・check mode 対応・使用例が同じ形式で載っている6。
ansibleパッケージに同梱される collection だけでも、amazon・cisco・community・vmware など多数の名前空間がある7。role と collection の共有基盤として Ansible Galaxy があり8、4章で触れる NVIDIA のドライバ role も Galaxy からnvidia.nvidia_driverとして入れられる9。質問や議論の場として Ansible Forum もある10 - エージェントも同じ情報源を使える:
ansible-doc community.docker.docker_compose_v2のように、制御ノード上でモジュールのドキュメントを引ける。エージェントにこれを実行させてから書かせると、記憶に頼ったパラメータの誤りを減らせる - 社内でも共有しやすい: 書き方が揃っているので、別チームが書いた role でも読み解ける
1.5 YAML と HCL:記法と抽象化の単位
1.3節の利点は Terraform にも当てはまる。どちらも記法をツールが担保し、抽象化の単位が決まっている。違うのは、汎用フォーマットに乗るか、専用の設定言語を持つかだ。
| 観点 | Ansible(YAML) | Terraform(HCL) |
|---|---|---|
| 記法 | 汎用データ形式の YAML | HashiCorp 製の設定言語 HCL(Terraform の言語はこれに基づく)11 |
| 整形・検査 | yamllint、ansible-lint | terraform fmt が正規の書式に整形し、-check で未整形を検出できる12 |
| 抽象化の単位 | role、collection | module(一緒に管理するリソースの集合)13 |
| 変更の確認 | --check --diff | terraform plan |
YAML の良さは、汎用フォーマットであること。yq や Python でそのまま解析できるので、「全 playbook から shell: を使っている箇所を抜き出す」「group_vars のドライバブランチを一覧にする」といった処理を、専用のパーサなしで書ける。インデントとキー・値だけなので、Ansible を書かないレビュー担当でも何をしているかを追える。CI 設定や Compose などで見慣れた形式なので、エージェントも書き慣れている印象がある(定量的な根拠はない)。
HCL の良さは、書式がツールで1つに決まること12。CI で terraform fmt -check を回せば、エージェントが書いたコードの見た目の揺れを機械的にゼロにできる。また、module が抽象化の境界になり、利用側は入力変数だけを渡す13。エージェントには「レビュー済みの module を呼び出すコードだけを書かせる」という制約をかけやすい。
module "gpu_node" { source = "./modules/gpu_node" instance_type = "g6.xlarge" count = 2}YAML には落とし穴もある。YAML 1.1 では yes / no / on / off が真偽値として解釈されうる。yamllint の truthy ルールは、既定で true / false 以外を検出する14。ドライバのブランチ番号のように文字列として扱いたい値も、"580" と引用符で囲んでおくほうが安全だ(4章の例でもそうしている)。
2. エージェント運用のガードレール
2.1 ansible-lint で「shell への逃げ」を止める
エージェントは適切なモジュールが分からないと shell: で済ませがちだ。ansible-lint の次のルールで検出できる2。
| ルール | 検出内容 | 含まれる最小プロファイル3 |
|---|---|---|
command-instead-of-module | 専用モジュールがあるのに command を使っている | basic |
command-instead-of-shell | shell が不要な場面で shell を使っている | basic |
risky-shell-pipe | パイプの失敗を見落とす shell 記述 | safety |
no-changed-when | command / shell に changed_when がない(冪等性の宣言漏れ) | shared |
プロファイルは min → basic → moderate → safety → shared → production の順に厳しくなり、上位は下位を包含する3。エージェントが書くコードには production(少なくとも shared)を指定すると、上の4ルールがすべて効く。
profile: productionなお、ルールの所属プロファイルはバージョンで変わる可能性がある。導入時に ansible-lint --list-profiles で確認しておく。
2.2 Molecule で冪等性をテストする
Molecule は role・playbook・collection のテストフレームワークで、コンテナ・VM・ネットワーク機器などをテスト対象にできる4。デフォルトのテストシーケンスは次のとおりで、converge(適用)の直後に idempotence ステップがある5。
dependency → cleanup → destroy → syntax → create → prepare→ converge → idempotence → side_effect → verify → cleanup → destroyidempotence ステップは、一般に「もう一度流して changed が出ないこと」を確かめるものとして使われている。これを CI で回せば、エージェントの出力を人間が1行ずつ読む負担が減る。
2.3 変数の置き場所をルール化する
Ansible の変数の優先順位は 22段階ある15。YAML 自体は読みやすくても、「この値は最終的にどこから来るのか」を追うのは難しくなりやすい。エージェントへの指示(CLAUDE.md や AGENTS.md)に、次のようなルールを入れておくとレビューしやすさを保てる。
- 環境差分は
group_vars//host_vars/に寄せる - role のデフォルト値は
defaults/main.ymlだけに置く -e(extra vars、最優先15)は緊急時以外使わない- Jinja2 テンプレートに複雑な条件分岐を書かない
2.4 ドリフト検知
冪等でも、手作業の変更は Ansible を流さない限り見つからない。対策として、定期的に --check --diff を流し、changed が出たらドリフトとして通知する運用が紹介されている16。さらに進めると、Event-Driven Ansible(ansible-rulebook)17でイベントを受けて修復用の playbook を起動する構成も考えられる。ただ、こちらは公式の専用ガイドが見当たらず、デモやコミュニティ事例が中心だ。
2.5 推奨フロー
ここまでを1本のフローにすると次のようになる。
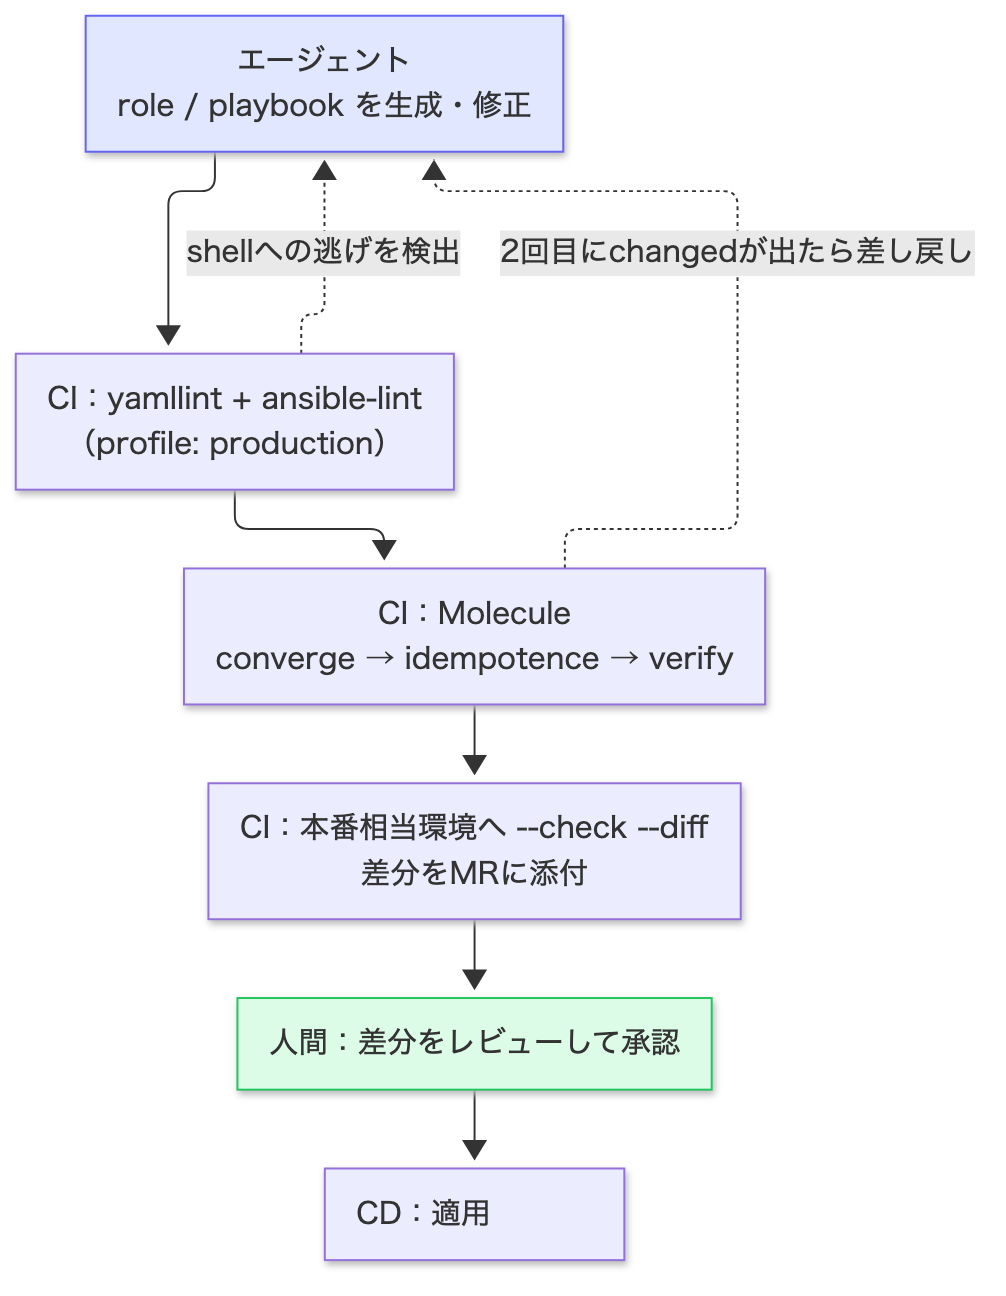
エージェントの担当は「書く」まで、人間の担当は「差分を承認する」だけ、という分担にできる。
2.6 Claude Code に当てはめると
普段 Claude Code で作業しているなら、上のガードレールは次の場所に置ける。
| ガードレール | Claude Code での置き場所 |
|---|---|
変数の置き場所ルール、shell: を使わない方針 | CLAUDE.md に書いておく |
| ansible-lint を毎回通す | hooks で、YAML の編集後に ansible-lint を自動実行する |
| 本番への適用は人間が承認する | 権限設定で ansible-playbook の実行を確認付きにする |
| 差分を見てから適用する | エージェントに --check --diff まで流させ、出力そのものを人間が読んで判断する |
スクリプトを書かせる場合との違いは、検査の対象が「エージェントが毎回違う形で書いたコード」ではなく「決まった形のYAMLと、その差分」になることだ。
3. クラウドとオンプレでの使い分け
よく言われる役割分担は、クラウドは Terraform で箱を作り、Ansible で中身を設定するというもの。VPC・IAM・RDS のように「作る・消す」が中心で状態管理が必要な層は Terraform が向く。terraform plan の差分レビューも、--check --diff と同じく「エージェントが書き、人間が差分を承認する」フローに乗る。
オンプレでは「API でリソースを作る」場面が減り、既に存在する物理機器を設定する場面が増える。ここは Ansible の得意領域で、1つのツールで次の層をまとめて扱える。
| 層 | 主なモジュール・collection | 用途 |
|---|---|---|
| ハードウェア(BMC) | community.general.redfish_command など18 | 電源操作、BMC ユーザー管理、ログ管理 |
| ネットワーク機器 | 各ベンダーのネットワークリソースモジュール19 | VLAN・インターフェース設定、設定の取得 |
| 仮想化基盤 | community.proxmox.proxmox_kvm20、VMware 系 collection | VM 作成・設定 |
| OS・ミドルウェア | ansible.builtin.*、各種 collection | パッケージ、設定ファイル、サービス、ユーザー |
エージェントに任せるときに気をつけたい点もある。
- ネットワークリソースモジュールの
state: gatheredで現在の設定を構造化データとして取れる19。エージェントにまず現状を読ませてから変更案を作らせる、という使い方ができる state: overriddenは、公式ドキュメント自体が「デバイスへのアクセスを失う可能性がある」と警告している19。エージェントにはmerged/replacedだけを許可するのが安全redfish_commandは check mode に対応していない18。電源操作のような破壊的な操作は、エージェントに実行させず、人間の承認を必ず挟む
Terraform もオンプレで使えなくはなく、vSphere 用のプロバイダなどがある21。ただ、物理機器の設定や OS の内部まではカバーしないので、オンプレでは Ansible が主役になりやすい、というのが個人的な見立てだ。
4. サンプル構築例:GPU サーバーにサービスを立てて引き渡す
ここからは、調べた内容を具体化するためのサンプルである。開発者が素の OS から GPU サーバーを構築し、推論サービスを Docker で動かし、最後にインフラ担当へ引き渡す、という想定で組み立てた。
狙いは「開発環境で通した playbook を、inventory だけ差し替えて本番で流す」こと。インフラ担当は検証済みの手順を実行するだけになり、手順書の読み違いや転記ミスがなくなる。
4.1 Ansible と Docker の責務を分ける
| 層 | 担当 | 中身 |
|---|---|---|
| ホスト | Ansible | NVIDIA ドライバ、Docker Engine、NVIDIA Container Toolkit、ユーザー・ディレクトリ、ファイアウォール |
| デプロイ | Ansible | compose.yaml・.env の配置、docker compose up |
| アプリ | Docker(イメージ) | CUDA ランタイム、Python・ライブラリ、推論コード |
NVIDIA Container Toolkit はホストにドライバが入っていることを前提にしている22。なのでドライバはホスト側にだけ入れ、コンテナ側は CUDA のユーザー空間ライブラリだけを持つ構成にする。
もう1つの原則は、Dockerfile の中で Ansible を使わないこと。イメージの中身は Dockerfile と CI で作り、Ansible は「どのイメージを、どの設定で起動するか」だけを担当する。こうすると境界がはっきりする。
4.2 ドライバと CUDA は1本の鎖
コンテナ化しても、ホストのドライバとコンテナ内の CUDA のバージョンだけは連動する。NVIDIA の minor version compatibility で求められる Linux ドライバの最低バージョンは次のとおり23。
| コンテナ内の CUDA | ホストのドライバ |
|---|---|
| 12.x | 525 以上 |
| 13.x | 580 以上 |
さらに PyTorch の pip wheel は、CUDA ランタイム・cuDNN・NCCL などを nvidia-* の pip パッケージとして依存に持つ24。CUDA のユーザー空間ライブラリはコンテナ内の Python の依存として入り、ホストに必要なのはドライバだけになる。つまり次の4つは1本の鎖でつながっている。
ホストのドライバ(branch 580) └─ 対応できる CUDA の範囲(13.x まで) └─ コンテナ内の torch の CUDA variant と nvidia-* pip パッケージ └─ 推論速度・使えるカーネル(cuDNN / NCCL のバージョン)速度やライブラリのバージョンを決めるのは開発者なので、鎖の根元のドライバも開発側で持つのが筋が通っている。そのうえで、ドライバを入れた後に要件を満たしているかを検査するタスクを残しておく。誰かが手作業でドライバを変えた場合にも、デプロイ前に止められる。
gpu_driver_branch: "580"gpu_min_driver_major: 580 # CUDA 13.x イメージを使う場合
# roles/gpu_host/tasks/check_driver.yml- name: Get driver version ansible.builtin.command: nvidia-smi --query-gpu=driver_version --format=csv,noheader register: gpu_driver changed_when: false
- name: Assert driver meets CUDA requirement ansible.builtin.assert: that: - (gpu_driver.stdout_lines[0].split('.')[0] | int) >= gpu_min_driver_major fail_msg: "Driver {{ gpu_driver.stdout_lines[0] }} < {{ gpu_min_driver_major }}"command を使っているが、changed_when: false で「状態を変えない読み取り」だと宣言しているので、no-changed-when には引っかからない。
4.3 ドライバのブランチを選んで固定する
NVIDIA のデータセンター向けドライバには3種類のブランチがある25。
| ブランチ | サポート期間 | 用途 |
|---|---|---|
| New Feature Branch(NFB) | なし | 新機能の評価用。本番には使わない |
| Production Branch(PB) | 最大1年 | 本番向け |
| Long-Term Support Branch(LTSB) | 3年 | 長期間更新したくない本番向け |
本番は PB か LTSB を選び、ブランチ単位で固定する。Ubuntu では、NVIDIA が提供する pinning パッケージ(例: nvidia-driver-pinning-580)をドライバより先に入れるのが推奨されている26。意図しない apt upgrade でブランチが変わるのを防げる。カーネルモジュールは open 版(nvidia-open パッケージ)で入れる27。
# roles/gpu_host/tasks/driver.yml(CUDA の apt リポジトリ追加は省略)- name: Pin driver branch ansible.builtin.apt: name: "nvidia-driver-pinning-{{ gpu_driver_branch }}" state: present
- name: Install NVIDIA driver (open kernel modules) ansible.builtin.apt: name: nvidia-open state: present register: driver_install
- name: Reboot if driver changed ansible.builtin.reboot: when: driver_install is changedただし Ubuntu では、580 以前のブランチはパッケージ名にブランチ番号が入っていて、upgrade / downgrade でのブランチ切り替えがサポートされるのは 590 以降だけ、という制約がある26。別案として NVIDIA 公式の role(nvidia.nvidia_driver)もあり、インストール時にノードを再起動するため、GPU ノードとは別のノードから実行することが推奨されている9。再起動には ansible.builtin.reboot を使えば、ホストの復帰待ちまで含めて扱える28。
4.4 更新はローリングで(設計案)
ドライバ更新では再起動が必要になり、サービスが止まる。複数台あるなら serial で1台ずつ進める29。以下は公式機能を組み合わせた設計案で、実機で検証したものではない。
- name: Rolling driver update hosts: gpu_servers serial: 1 # 1台ずつ。[1, "50%"] のように段階的にもできる tasks: - name: Stop service community.docker.docker_compose_v2: project_src: /opt/inference state: stopped - name: Update driver via gpu_host role ansible.builtin.import_role: name: gpu_host # pinning 切替 → ドライバ更新 → reboot → assert - name: Smoke test (GPU visible from container) ansible.builtin.command: docker run --rm --gpus all ubuntu nvidia-smi changed_when: false - name: Start service community.docker.docker_compose_v2: project_src: /opt/inference state: present1台目でスモークテストが落ちれば、残りの台には進まない。「検証済みの手順で実行するだけ」を更新作業にも広げる仕組みになる。
また、ドライバのカーネルモジュールは実行中のカーネルと組み合わせて動く。一般的な運用知見として、カーネルの自動更新後にモジュールがロードできず GPU が見えなくなるケースが知られているので、カーネル更新もドライバ更新と同じ playbook で扱い、unattended-upgrades に任せきりにしないほうが安全だ(挙動は DKMS かプリビルドかで変わる)。
4.5 コンテナ実行環境とデプロイ
NVIDIA Container Toolkit の公式手順は、apt リポジトリを追加 → パッケージをインストール → nvidia-ctk runtime configure --runtime=docker → Docker 再起動、という流れになっている22。
nvidia-ctk runtime configure は /etc/docker/daemon.json を書き換えるコマンドだ22。そのまま command で呼ぶと冪等性が崩れ、ansible-lint にも指摘される。代わりに、同じ内容の daemon.json をテンプレートで管理すると diff でレビューでき、冪等にもなる。生成内容はバージョンで変わりうるので、一度実機で nvidia-ctk を実行し、出力をコピーしてテンプレートにするのが確実だ。
- name: Install NVIDIA Container Toolkit (version pinned) ansible.builtin.apt: name: - "nvidia-container-toolkit={{ nvidia_ctk_version }}" - "nvidia-container-toolkit-base={{ nvidia_ctk_version }}" - "libnvidia-container-tools={{ nvidia_ctk_version }}" - "libnvidia-container1={{ nvidia_ctk_version }}" state: present notify: Restart docker
- name: Configure Docker daemon (nvidia runtime) ansible.builtin.template: src: daemon.json.j2 dest: /etc/docker/daemon.json mode: "0644" notify: Restart dockercompose.yaml での GPU 指定は deploy.resources.reservations.devices を使う。capabilities は必須で、count と device_ids は同時に指定できない30。
services: inference: image: registry.example.com/team/inference@sha256:... # digest で固定 deploy: resources: reservations: devices: - driver: nvidia device_ids: ["0"] capabilities: [gpu]Ansible からは community.docker.docker_compose_v2 で起動する。このモジュールは check mode に対応している。ただし state: restarted と recreate: always は冪等ではないので、通常のデプロイでは使わない6。最後に、公式のサンプルワークロード31相当のスモークテストを changed_when: false で入れておくと、本番で流すたびに「GPU がコンテナから見える」ことを確認できる。
4.6 引き渡し物の構成
gpu-service-deploy/├── roles/│ ├── gpu_host/ # ドライバ導入・固定・検査, Docker, Container Toolkit│ └── app_deploy/ # compose.yaml・.env 配置と起動├── inventories/│ ├── dev/ # 開発者が管理・検証済み│ └── prod/ # インフラが記入(ホスト名、Vault)├── group_vars/│ └── gpu_servers.yml # ドライバブランチ・イメージ digest をまとめて管理├── site.yml # 素の OS からの初期構築├── driver_update.yml # ローリングでのドライバ更新├── molecule/ # OS 層のテスト└── README.md # 前提条件・変数一覧・実行コマンド| 項目 | 開発者 | インフラ |
|---|---|---|
| role・playbook・compose.yaml | 作成・検証 | レビュー |
| ドライバのブランチ選定・更新タイミング | 決定・dev 環境で検証 | 更新の実施日を調整 |
inventories/prod・Vault | 変数の雛形を用意 | 値を記入・管理 |
| 本番実行 | — | --check --diff を確認してから実行 |
引き渡しで効くのはバージョンの固定だ。ドライバのブランチ、Container Toolkit のバージョン、イメージの digest を group_vars に並べ、同じ MR でまとめて変えるルールにしておけば、「開発で通ったものと同じもの」が本番で動くことを保証しやすくなる。
テストには限界もある。Molecule のコンテナには GPU がないので、OS 層は Molecule、GPU 層は開発用 GPU サーバーを実機テスト環境として使う。エージェントに任せやすいのは、role の作成と開発用サーバーでの「流す → 直す」の反復で、本番への実行は人間が差分を見てから行う。
5. 依存関係の可視化
Ansible を試してよかったのは、この可視化の道具がそろっていることだった。エージェントが書いた playbook をレビューするとき、YAML を1ファイルずつ読むだけでは「どの role がどの順で呼ばれ、どのホストに当たるか」をつかみにくい。次の4つの見方を組み合わせる。
| 何を見たいか | ツール | 出力 |
|---|---|---|
| playbook → play → role → task の構造 | ansible-playbook-grapher32 | SVG / Mermaid / JSON |
| どのホストがどのグループに属し、どの変数を持つか | ansible-inventory --graph --vars33 | テキストのツリー |
| 実行されるタスク・タグ・ホストの一覧 | ansible-playbook --list-tasks など34 | テキスト |
| 実際の実行結果の履歴 | ARA Records Ansible35 | Web UI / CLI / REST API |
5.1 playbook の構造:ansible-playbook-grapher
playbook を静的に解析して、play・role・task の関係をグラフにするツールだ。インベントリに対しては何も実行しない32。
pip install ansible-playbook-grapher
# role 内のタスクまで含めて SVG で出力(Graphviz が必要)ansible-playbook-grapher --include-role-tasks --show-handlers site.yml -o docs/site
# Mermaid で出力(Markdown に埋め込める)ansible-playbook-grapher --include-role-tasks --renderer mermaid-flowchart site.yml -o docs/site| オプション | 内容 |
|---|---|
--include-role-tasks | role 内のタスクもグラフに含める |
--renderer | graphviz(既定、SVG)/ mermaid-flowchart / json |
--show-handlers | handler も表示する |
-t / --skip-tags | タグで絞り込む |
--group-roles-by-name | 同名の role を1つのノードにまとめる |
4章のサンプル(site.yml)なら、次のような形のグラフになる。
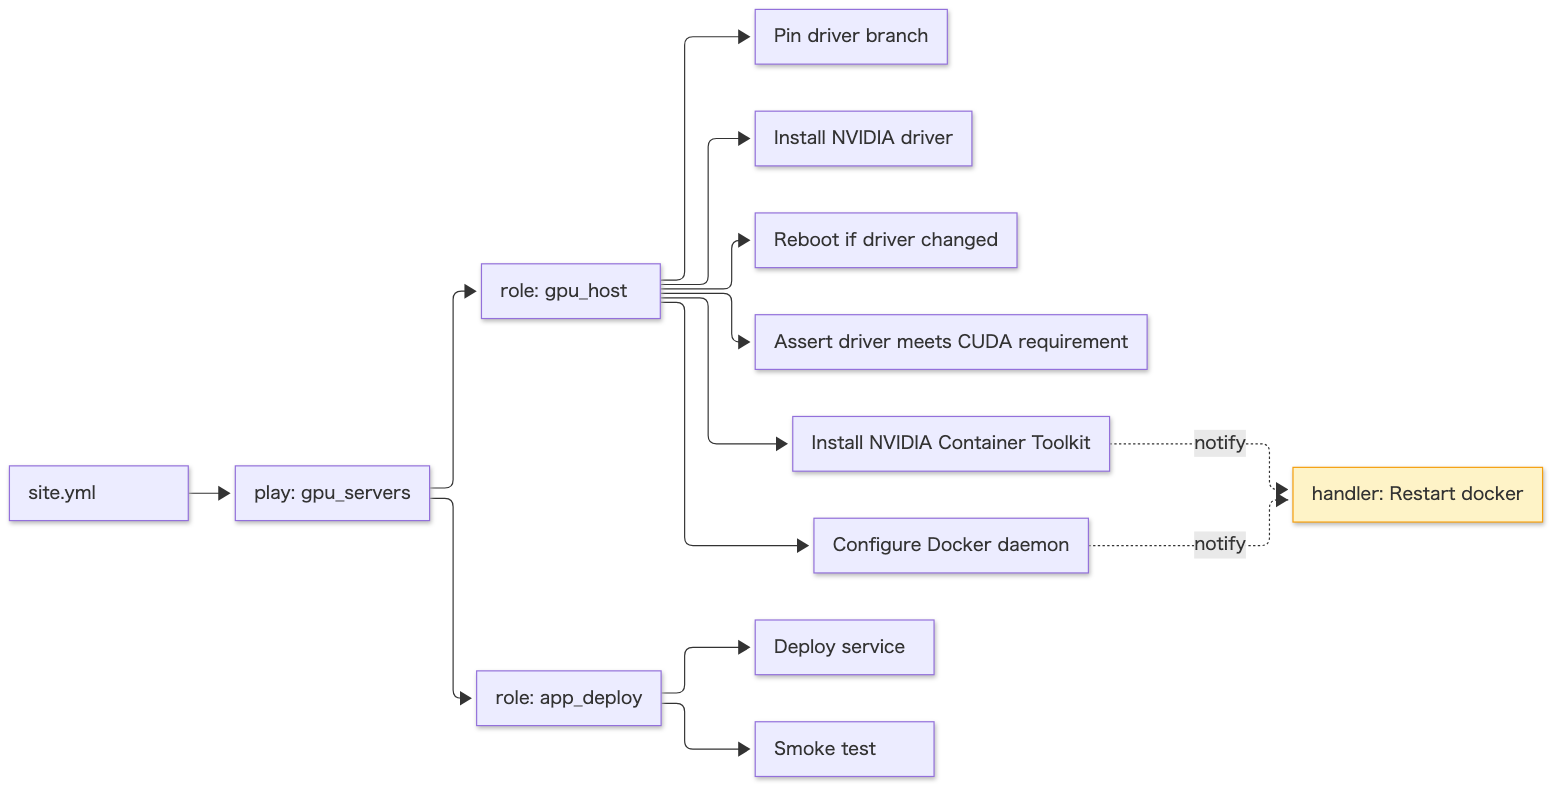
NOTEこの図は出力のイメージを手で描いたもので、grapher の実際の出力とはノードの形や表記が異なる。
レビューで効く使い方は2つある。
- CI で Mermaid を生成して MR に貼る: エージェントが role を追加したり、タスクの順序を変えたりしたとき、構造の変化が図の差分として見える。「Container Toolkit の導入がドライバの検査より前に来ている」といった順序の誤りに気づきやすい
- handler の通知先を確認する:
--show-handlersを付けると、どのタスクがどの handler を呼ぶかが見える。Restart dockerが想定外のタスクから呼ばれていないかを確認できる
5.2 インベントリの構造:ansible-inventory —graph
ansible-inventory -i inventories/prod --graph --vars--graph はグループとホストのツリーを出力し、--vars を付けると各ホスト・グループの変数も表示する(--vars は --graph と組み合わせたときだけ有効)33。出力はおおよそ次のような形になる(ホスト名は例)。
@all: |--@ungrouped: |--@gpu_servers: | |--gpu01 | | |--{gpu_driver_branch = 580} | | |--{gpu_min_driver_major = 580} | |--gpu02 | | |--{gpu_driver_branch = 580} | | |--{gpu_min_driver_major = 580}2.3節の「変数の優先順位が22段階あって追いにくい」問題への対策になる。group_vars と host_vars を合成した最終的な値を、ホストごとに確認できる。インフラ担当が inventories/prod を書いた後にこれを流せば、記入漏れや値の食い違いを一覧で確認できる。
5.3 実行計画の一覧:ansible-playbook —list-*
ansible-playbook -i inventories/prod driver_update.yml --list-hosts # 対象ホストansible-playbook -i inventories/prod driver_update.yml --list-tasks # 実行されるタスクansible-playbook -i inventories/prod driver_update.yml --list-tags # 利用可能なタグいずれも何も実行しない34。--check --diff が「何が変わるか」を示すのに対し、こちらは「何が、どのホストに対して走るか」を示す。
5.4 実行結果の履歴:ARA Records Ansible
ARA は Ansible の callback plugin として動き、ansible-playbook の実行結果(play・task・ホストごとの結果)を記録する。既定ではローカルの SQLite に保存し、Web UI・CLI・REST API で参照できる35。
pip install "ara[server]"export ANSIBLE_CALLBACK_PLUGINS="$(python3 -m ara.setup.callback_plugins)"ansible-playbook -i inventories/dev site.ymlara-manage runserver # http://127.0.0.1:8000callback の設定方法はバージョンで変わりうるので、導入時に公式ドキュメントで確認しておく。「いつ、どのホストで、何が changed になったか」を後から追いたい作業で役に立つ。エージェントが開発環境で繰り返した実行の履歴を、後から人間が確認する用途にも使える。
5.5 レビューフローへの組み込み
2.5節のフローに、可視化を足すと次のようになる。
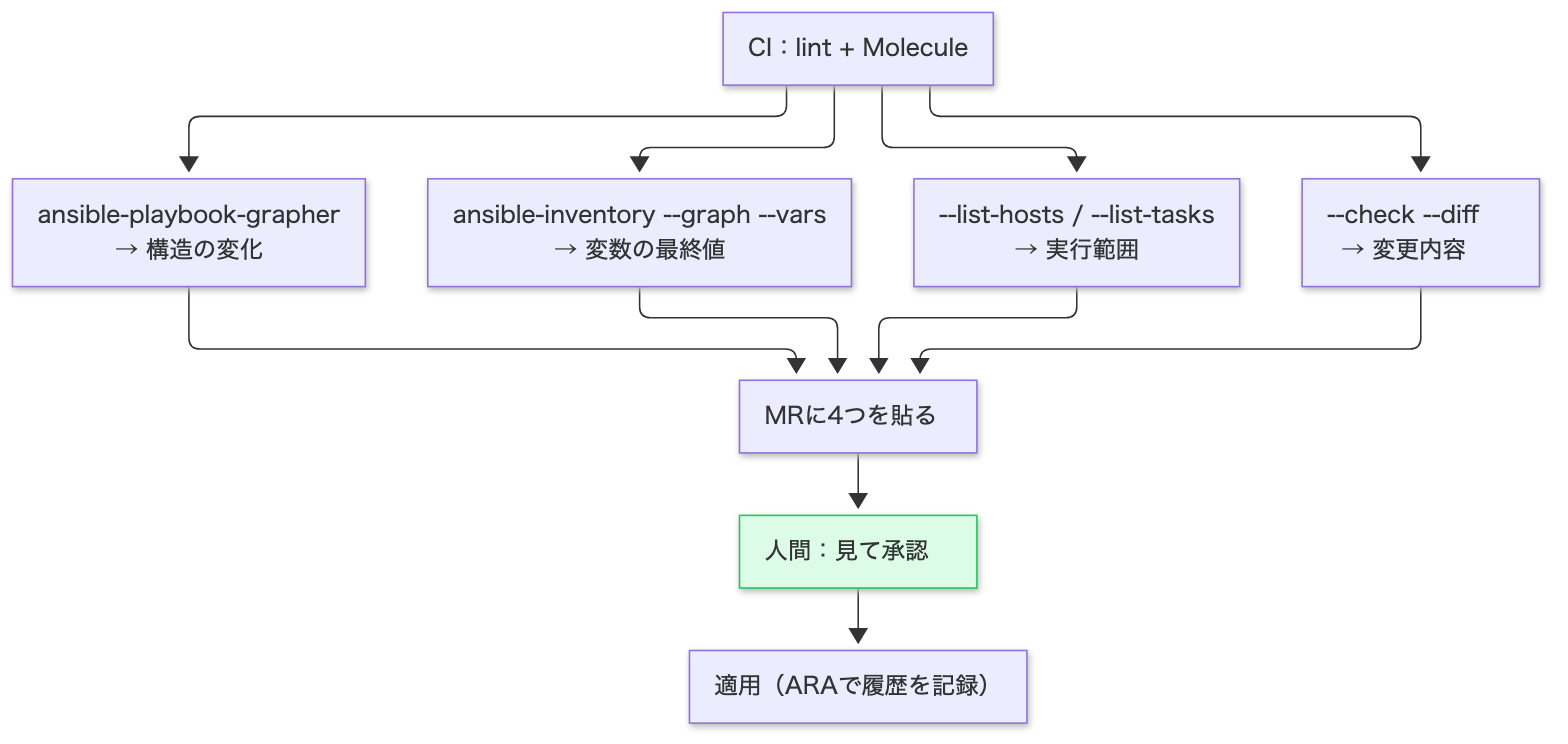
構造・値・範囲・変更内容の4つが図とテキストで並ぶので、AIが書いたYAMLを頭の中で実行しなくても判断できる。散らかったスクリプトを読む場合との大きな差はここにある。
まとめ
| 環境 | 推奨構成 | エージェントの関わり方 |
|---|---|---|
| クラウド | Terraform(箱)+ Ansible(中身) | plan と --check --diff の差分を人間が承認 |
| オンプレ | Ansible が主役(BMC・ネットワーク・仮想化・OS) | gathered で現状把握 → 変更案 → 差分承認。電源操作など破壊的な操作は人間が実行 |
| GPU サーバー+Docker(サンプル) | Ansible(ホスト・デプロイ)+ Docker(アプリ) | 開発環境で反復 → inventory を差し替えて本番へ引き渡し |
| 共通 | ansible-lint(production)+ Molecule(idempotence) | lint とテストに通らないものはマージしない |
| 可視化 | grapher(構造)+ inventory —graph(変数)+ —list-*(範囲)+ ARA(履歴) | CI で生成して MR に貼り、レビューの材料にする |
AIエージェントのおかげで、構築の手順を書くコストはほぼゼロになった。そのぶん、書かれたものを人間がレビューできる形に保つことの価値が上がっている。シェルやPythonのスクリプトを書かせ続けるより、出力の形が決まっていて、差分と構造を見せてくれるフレームワークに寄せたほうが、構築の再現性は上げやすい。Ansible はそのためのフレームワークとして、よい選択肢なのではないかと思う。
参考文献
- Ansible Documentation - Validating tasks: check mode and diff mode https://docs.ansible.com/ansible/latest/playbook_guide/playbooks_checkmode.html
- Ansible Lint Documentation - Rules https://docs.ansible.com/projects/lint/rules/
- Ansible Lint Documentation - Profiles https://docs.ansible.com/projects/lint/profiles/
- Molecule Documentation https://docs.ansible.com/projects/molecule/
- Molecule Documentation - Configuration(test_sequence) https://docs.ansible.com/projects/molecule/configuration/
- community.docker.docker_compose_v2 module https://docs.ansible.com/ansible/latest/collections/community/docker/docker_compose_v2_module.html
- Ansible Documentation - Collection Index https://docs.ansible.com/ansible/latest/collections/index.html
- Ansible Galaxy https://galaxy.ansible.com/
- NVIDIA/ansible-role-nvidia-driver https://github.com/NVIDIA/ansible-role-nvidia-driver
- Ansible Community Forum https://forum.ansible.com/
- Terraform Documentation - Configuration Syntax https://developer.hashicorp.com/terraform/language/syntax/configuration
- Terraform CLI - terraform fmt https://developer.hashicorp.com/terraform/cli/commands/fmt
- Terraform Documentation - Modules https://developer.hashicorp.com/terraform/language/modules
- yamllint - Rules(truthy) https://yamllint.readthedocs.io/en/stable/rules.html
- Ansible Documentation - Using variables(Variable precedence) https://docs.ansible.com/ansible/latest/playbook_guide/playbooks_variables.html
- Spacelift - Ansible configuration drift management https://spacelift.io/blog/ansible-configuration-drift-management
- Ansible Rulebook Documentation - Getting started https://docs.ansible.com/projects/rulebook/en/v1.2.0/getting_started.html
- community.general.redfish_command module https://docs.ansible.com/ansible/latest/collections/community/general/redfish_command_module.html
- Ansible Documentation - Network Resource Modules https://docs.ansible.com/ansible/latest/network/user_guide/network_resource_modules.html
- community.proxmox collection https://docs.ansible.com/ansible/latest/collections/community/proxmox/index.html
- Terraform Provider for VMware vSphere https://github.com/vmware/terraform-provider-vsphere
- NVIDIA Container Toolkit - Installation Guide https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html
- NVIDIA CUDA Toolkit Release Notes(minor version compatibility) https://docs.nvidia.com/cuda/cuda-toolkit-release-notes/index.html
- PyTorch Forums - Where and how do pip installs of Pytorch install CUDA https://discuss.pytorch.org/t/where-and-how-do-pip-installs-of-pytorch-install-cuda/129760
- NVIDIA Data Center Drivers - Driver Lifecycle https://docs.nvidia.com/datacenter/tesla/drivers/driver-lifecycle.html
- NVIDIA Driver Installation Guide - Version locking https://docs.nvidia.com/datacenter/tesla/driver-installation-guide/version-locking.html
- NVIDIA Driver Installation Guide - Kernel Modules https://docs.nvidia.com/datacenter/tesla/driver-installation-guide/kernel-modules.html
- ansible.builtin.reboot module https://docs.ansible.com/ansible/latest/collections/ansible/builtin/reboot_module.html
- Ansible Documentation - Controlling playbook execution: strategies and more(serial) https://docs.ansible.com/ansible/latest/playbook_guide/playbooks_strategies.html
- Docker Docs - Enable GPU support(Compose) https://docs.docker.com/compose/how-tos/gpu-support/
- NVIDIA Container Toolkit - Running a Sample Workload https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/sample-workload.html
- ansible-playbook-grapher https://github.com/haidaraM/ansible-playbook-grapher
- Ansible Documentation - ansible-inventory https://docs.ansible.com/ansible/latest/cli/ansible-inventory.html
- Ansible Documentation - ansible-playbook https://docs.ansible.com/ansible/latest/cli/ansible-playbook.html
- ARA Records Ansible https://ara.recordsansible.org/